SwarmWorld: 말 없이 협력하는 LLM 에이전트 사회와 창작자보다 오래 남는 기술
SwarmWorld에서는 에이전트가 대화하지 않아도 다른 에이전트가 남긴 장치와 환경 변화를 관찰하며 작업을 이어갑니다. 이 공유 세계는 독립 탐색보다 여러 기능을 갖춘 기술 집합을 만드는 데 유리했지만, 최고의 단일 장치까지 보장하지는 않았습니다. MIT 연구진의 논문이 보여 준 것은 정해진 시뮬레이터 안에서 결과물이 축적되는 협력입니다. 실제 재료를 발명했거나 현실의 멀티 에이전트 시스템이 항상 더 낫다는 증거로 확대하면 실험의 뜻이 달라집니다.
더 보기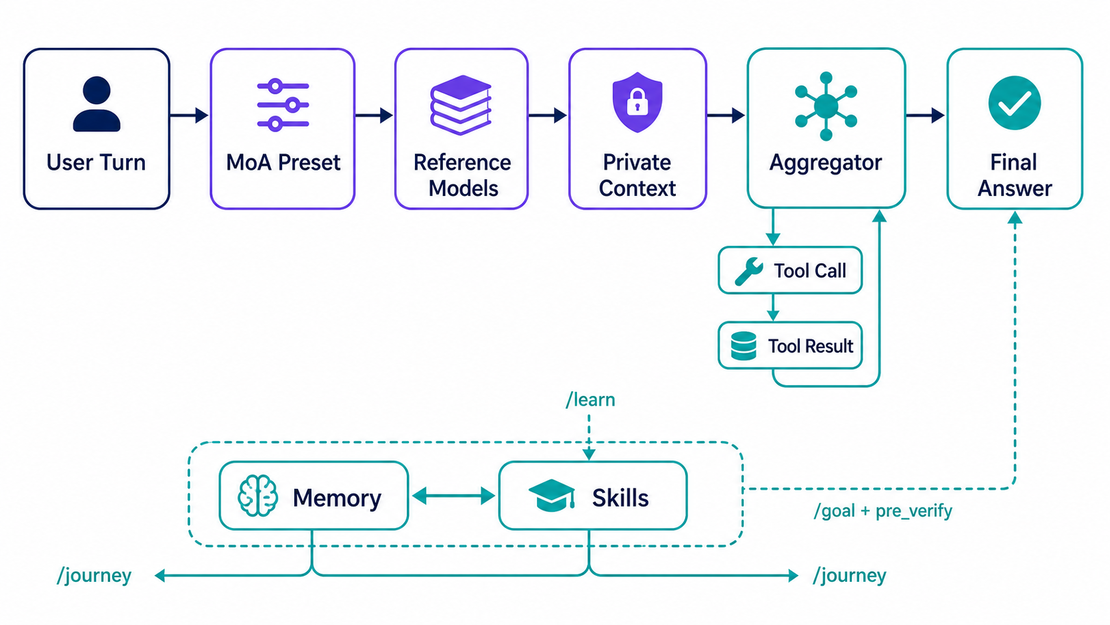
Hermes Agent v0.18: 스스로 배우는 에이전트와 MoA가 만났을 때
Nous Research가 만든 오픈소스 에이전트 Hermes Agent가 2026년 7월 1일 v0.18.0을 냈습니다. 릴리스 노트는 이번 버전을 “The Judgment Release"라고 부릅니다. 새 명령어 몇 개를 더한 마이너 업데이트로 보면 핵심을 놓치기 쉽습니다. 공식 문서는 Hermes Agent를 “스스로 배우는 AI 에이전트"라고 소개하는데, 실제로 이 프로젝트는 쓸수록 메모리와 스킬을 쌓아가는 학습 루프를 핵심 설계로 삼고 있습니다. 이 글은 그 자기개선 루프가 v0.18에서 어떻게 다듬어졌는지, 그리고 같은 버전에서 정식 모델 선택지가 된 Mixture of Agents(MoA)가 이 루프 안에서 어떤 역할을 맡는지를 정리합니다.
더 보기
TradingAgents: LLM 에이전트로 만든 트레이딩 회사, 논문과 코드 읽기
TradingAgents는 여러 LLM이 자료를 분석하고 반론을 검토해 한 종목의 투자 판단과 그 근거를 만드는 연구 프레임워크입니다. 현재 코드에서는 Trader의 거래 제안을 리스크 팀이 검토한 뒤 Portfolio Manager가 최종 등급을 결정합니다. 논문의 높은 백테스트 수익률만으로 이 등급이 실거래 수익으로 이어진다고 판단할 수는 없습니다. 최신 평가 코드도 주문 체결과 계좌 잔고를 모사하지 않는다고 명시합니다. 최종 결정 코드, 평가 코드
더 보기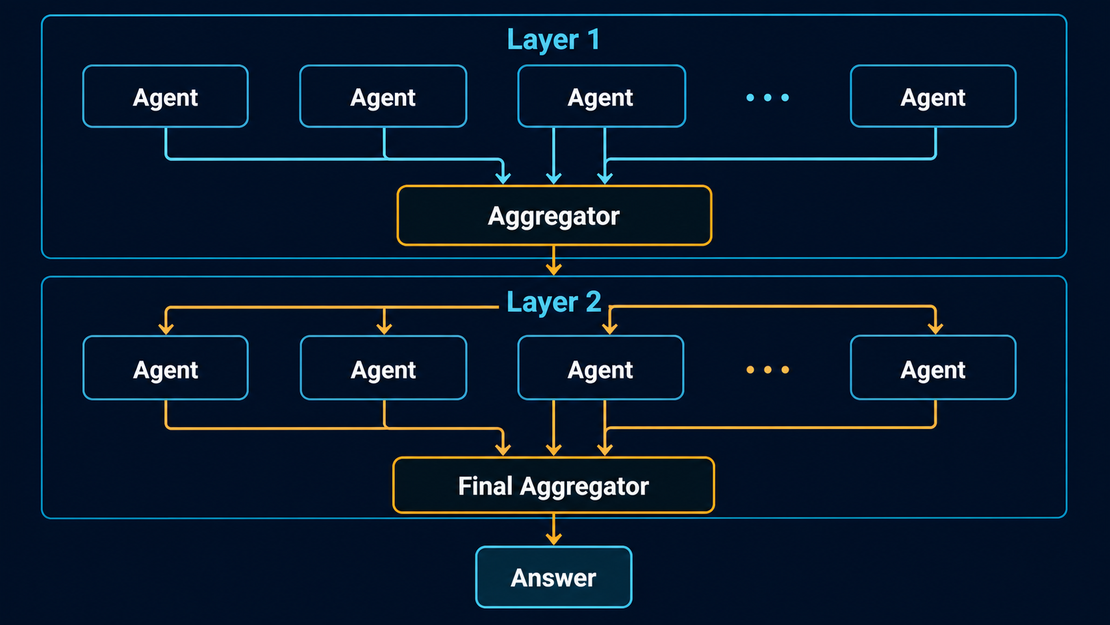
Mixture of Agents(MoA): 여러 LLM을 쌓아 GPT-4 Omni를 넘은 방법
모델 한 개를 더 크게 만드는 대신, 여러 모델을 계층으로 쌓아 서로의 출력을 다듬게 하는 방법이 있습니다. Together AI 연구진이 2024년 6월 발표한 논문 arXiv:2406.04692가 이 접근을 MoA(Mixture of Agents)라는 이름으로 정리했습니다. 오픈소스 모델만 조합한 MoA가 AlpacaEval 2.0에서 GPT-4 Omni를 7.6%p 앞섰습니다.
더 보기태그
- A2a
- Act
- Agent
- Agent-Debate
- Agent-Finance
- Agent-Harness
- Agent-Skills
- Agentic-Payments
- Ai-Agent
- Ai-Agents
- Ai-Architecture
- Ai-Blockchain
- Ai-Research
- Ai-Search
- Ai-Security
- Akash
- Anthropic
- Apify
- Base
- Benchmark
- Besu
- Bitcoin
- Bittensor
- Block-Access-Lists
- Canton
- Capital-Markets
- Ccip
- Cctp
- Chainlink
- Circle
- Coding
- Coding-Agent
- Coinbase
- Commerce
- Competition
- Compliance
- Context-Engineering
- Cross-Chain
- Cryptography
- Daml
- Data
- Data-Enclosure
- Data-Licensing
- Decentralized-Compute
- Depin
- Dex
- Diffusion-Policy
- Distillation
- Eip
- Eip-2780
- Eip-3009
- Eip-8037
- Eip-8038
- Emergent-Behavior
- Ensemble
- Enterprise-Blockchain
- Epbs
- Erc-8001
- Erc-8004
- Erc-8041
- Erc-8126
- Erc-8183
- Erc-8196
- Erc-8226
- Ethereum
- Evals
- Evaluation
- Evm
- Execution-Client
- Fhe
- Fido2
- Fintech
- Gas
- Glamsterdam
- Goldman-Sachs
- Google-Cloud
- Gpt-5-6
- Groth16
- Harness
- Heloc
- Hermes-Agent
- Identity
- Imitation-Learning
- Institutional-Finance
- Kimi
- Knowledge-Management
- Kya
- Langfuse
- Langgraph
- Lerobot
- Llama-Cpp
- Llm
- Llm-Agents
- Llm-as-Judge
- Llm-Observability
- Local-Llm
- Maci
- Math
- Mcp
- Memory
- Metadata
- Mev
- Moa
- Model-Routing
- Moe
- Mpp
- Mtp
- Multi-Agent
- Observability
- Okf
- Onchain
- Open-Source
- Open-Standard
- Opik
- Orderbook
- Passkey
- Physical-Ai
- Platforms
- Post-Quantum-Cryptography
- Post-Training
- Privacy
- Prompt-Engineering
- Provenance
- Python
- Qbft
- Quant-Finance
- Quantum-Computing
- Qwen
- Rag
- Reasoning
- Reinforcement-Learning
- Render
- Reputation
- Retrieval
- Reverse-Kl
- Rl
- Robot-Learning
- Rwa
- Search-Agent
- Security
- Self-Improvement
- Semaphore
- Settlement
- Skills
- Small-Language-Model
- Smart-Contract
- Smart-Contracts
- Smolvla
- Snark
- Software
- Solidity
- Sp1
- Stablecoin
- Stigmergy
- Swe-Bench
- Tokenization
- Tracing
- Trading
- Tutorial
- Ucp
- Uncensored
- Usdc
- Validators
- Vla
- Voting
- Wallet
- Webauthn
- X402
- Ylds
- Zero-Knowledge
- Zk-Proof
- Zk-Rollup