Kimi 요청을 Claude로 보냈다는 앤트로픽 보고서, 왜 공개했을까
민감한 정보가 Claude에 들어오고 있었다면, 앤트로픽은 왜 그 사실을 공개했을까요. 모델 제공사에는 그 입력을 더 관측하는 이익보다 무단 이용을 줄이고 고객의 데이터 처리 문제를 알리는 이익이 더 클 수 있습니다. 경쟁사의 요청에 계속 답하면 연산 자원을 쓰면서 경쟁 모델의 학습 자료까지 만들어 주는 셈입니다. 공개는 계정 차단만으로 닿기 어려운 이용자와 기업 고객에게도 문제를 알립니다. 다만 이는 공개의 이해관계를 설명하는 추론이며, 회사 내부의 의사결정이 확인됐다는 뜻은 아닙니다.
더 보기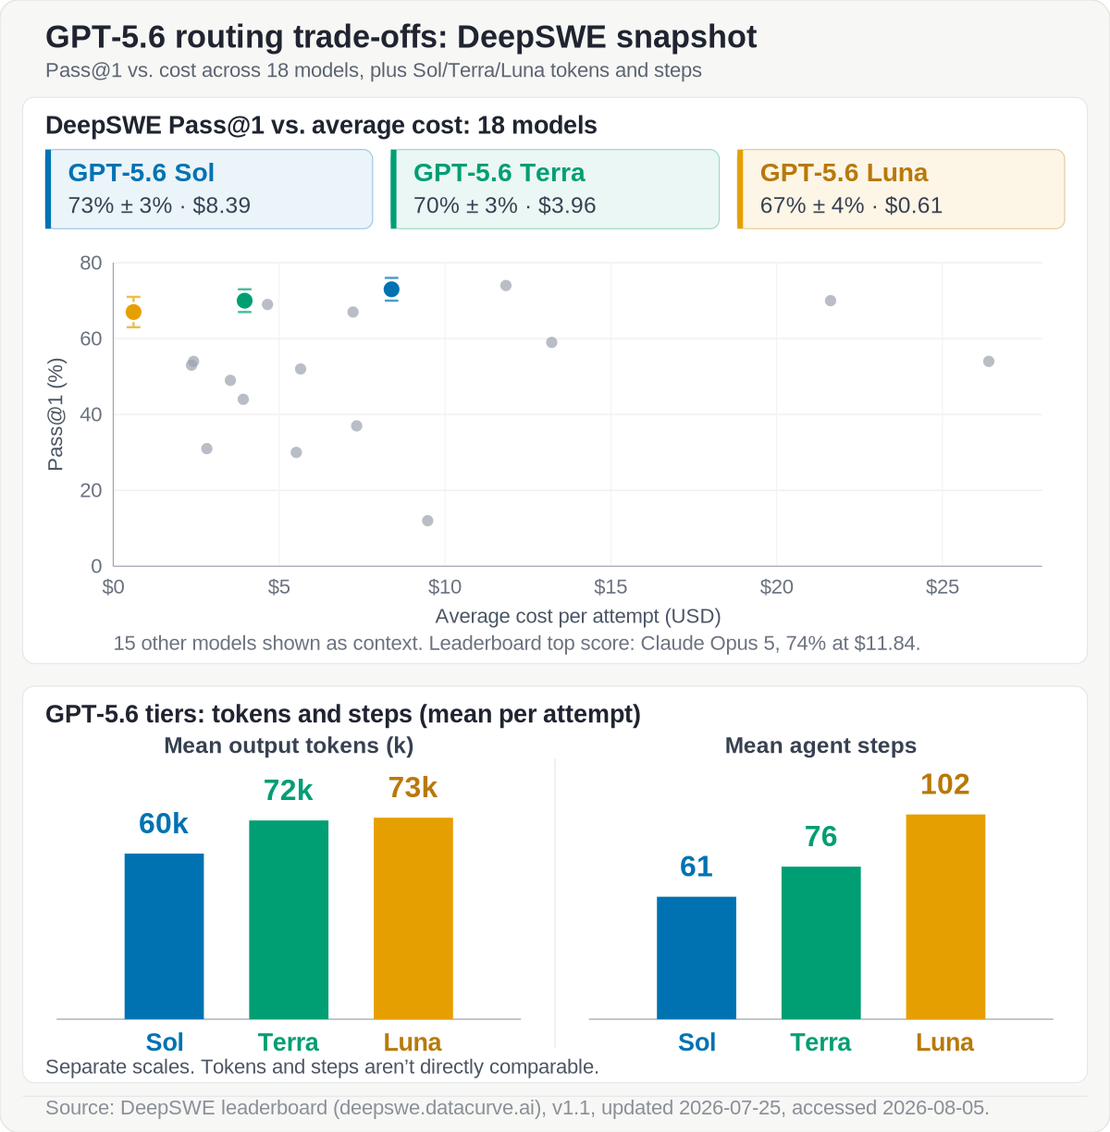
GPT-5.6 Sol·Terra·Luna 코딩 에이전트 모델 선택 가이드
GPT-5.6 이야기를 하다 보면 “Luna Max가 Terra High보다 낫다더라” 식의 서열이 자주 돌아다닙니다. 이 문장은 애초에 성립하지 않는 비교입니다. Sol·Terra·Luna는 서로 다른 모델(능력 티어)이고, max·high·xhigh·ultra는 같은 모델 안에서 얼마나 오래 생각하고 얼마나 많은 에이전트를 병렬로 굴릴지 정하는 설정입니다. 티어와 설정을 한 줄로 섞어 서열화하면 비교 축이 다른 값을 나란히 놓는 셈입니다.
더 보기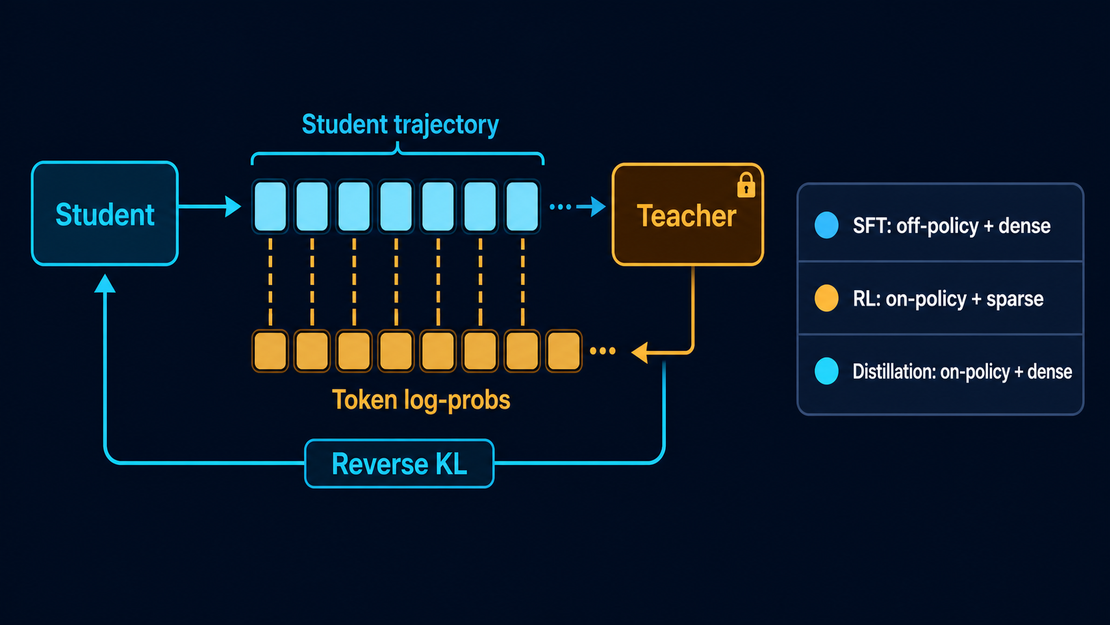
On-Policy Distillation: RL과 SFT 사이의 빈틈을 메우는 법
포스트 트레이닝에서 흔히 쓰는 두 방법에는 각자 구멍이 있습니다. SFT(supervised fine-tuning)는 교사가 만든 정답 시퀀스를 그대로 모방시키는데, 학생이 실제로 방문할 상태가 아닌 곳에서 배우다 보니 추론 단계가 길어질수록 오차가 쌓입니다. RL(강화학습)은 학생이 직접 생성한 궤적으로 배우니 이 문제는 없지만, 보상이 에피소드 하나당 한두 비트로 끝나는 경우가 많아 학습 신호가 지나치게 희박합니다. Thinking Machines Lab이 2025년 10월 공개한 글은 이 둘의 장점만 남기는 조합을 제안합니다. 학생이 스스로 궤적을 만들고, 강한 교사 모델이 그 궤적의 토큰 하나하나에 점수를 매기는 방식입니다.
더 보기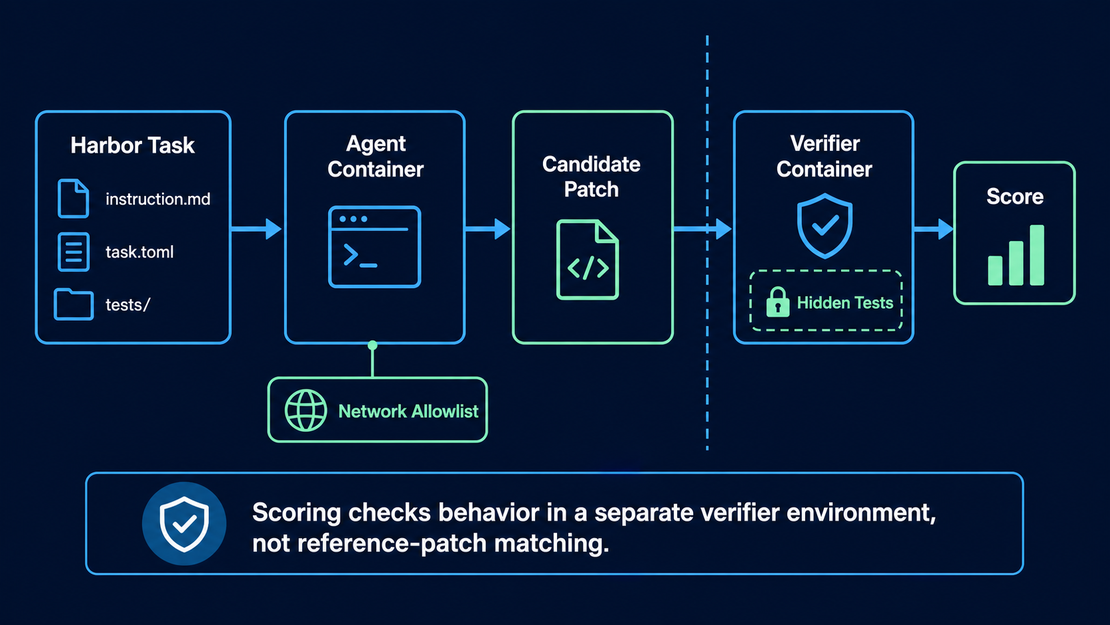
DeepSWE: 코딩 에이전트를 장기 과제로 평가하는 벤치마크
코딩 에이전트를 평가할 때 SWE-bench가 오랫동안 기준이었습니다. 그런데 SWE-bench의 태스크 대부분은 단일 파일 버그 수정이고, 정답이 이미 공개 커밋에 있습니다. 에이전트가 모델 학습 데이터에서 본 답을 그대로 재현하는 건지, 진짜로 코드를 이해하고 고치는 건지 구분하기 어렵습니다.
더 보기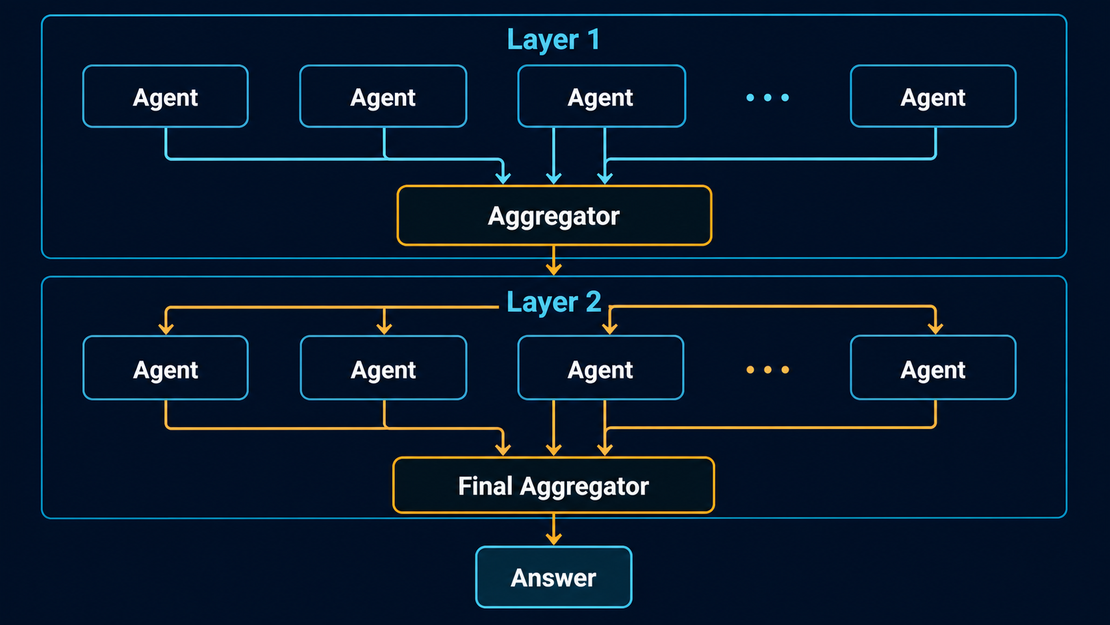
Mixture of Agents(MoA): 여러 LLM을 쌓아 GPT-4 Omni를 넘은 방법
모델 한 개를 더 크게 만드는 대신, 여러 모델을 계층으로 쌓아 서로의 출력을 다듬게 하는 방법이 있습니다. Together AI 연구진이 2024년 6월 발표한 논문 arXiv:2406.04692가 이 접근을 MoA(Mixture of Agents)라는 이름으로 정리했습니다. 오픈소스 모델만 조합한 MoA가 AlpacaEval 2.0에서 GPT-4 Omni를 7.6%p 앞섰습니다.
더 보기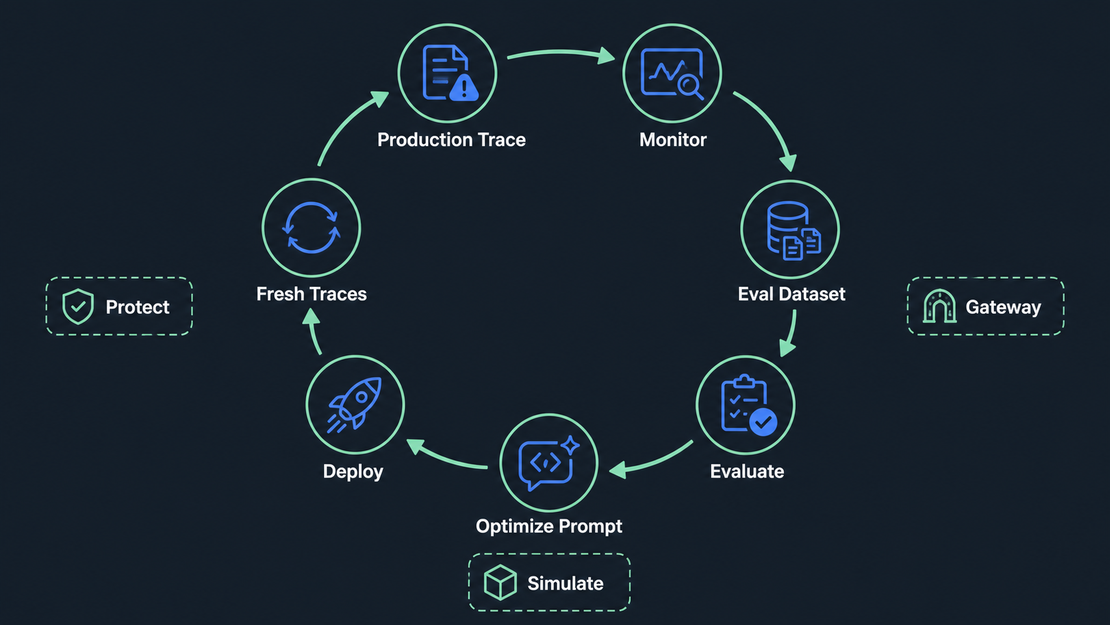
Future AGI: AI 에이전트 평가·관찰·개선을 한곳에서
AI 에이전트를 만들어 본 사람은 이 장면이 익숙합니다. 데모는 잘 돕니다. 그런데 프로덕션에 올리면 환각이 터지고, 뭐가 왜 틀렸는지 추적이 안 됩니다. 그래서 평가 도구 하나, 관측 도구 하나, 가드레일 하나를 따로 붙이죠. 진짜 문제는 이것들이 서로 말을 안 한다는 겁니다. 고치는 루프가 닫히지 않습니다.
더 보기태그
- A2a
- Act
- Agent
- Agent-Debate
- Agent-Finance
- Agent-Harness
- Agent-Skills
- Agentic-Payments
- Ai-Agent
- Ai-Agents
- Ai-Architecture
- Ai-Blockchain
- Ai-Research
- Ai-Search
- Ai-Security
- Akash
- Anthropic
- Apify
- Base
- Benchmark
- Besu
- Bitcoin
- Bittensor
- Block-Access-Lists
- Canton
- Capital-Markets
- Ccip
- Cctp
- Chainlink
- Circle
- Coding
- Coding-Agent
- Coinbase
- Commerce
- Competition
- Compliance
- Context-Engineering
- Cross-Chain
- Cryptography
- Daml
- Data
- Data-Enclosure
- Data-Licensing
- Decentralized-Compute
- Depin
- Dex
- Diffusion-Policy
- Distillation
- Eip
- Eip-2780
- Eip-3009
- Eip-8037
- Eip-8038
- Emergent-Behavior
- Ensemble
- Enterprise-Blockchain
- Epbs
- Erc-8001
- Erc-8004
- Erc-8041
- Erc-8126
- Erc-8183
- Erc-8196
- Erc-8226
- Ethereum
- Evals
- Evaluation
- Evm
- Execution-Client
- Fhe
- Fido2
- Fintech
- Gas
- Glamsterdam
- Goldman-Sachs
- Google-Cloud
- Gpt-5-6
- Groth16
- Harness
- Heloc
- Hermes-Agent
- Identity
- Imitation-Learning
- Institutional-Finance
- Kimi
- Knowledge-Management
- Kya
- Langfuse
- Langgraph
- Lerobot
- Llama-Cpp
- Llm
- Llm-Agents
- Llm-as-Judge
- Llm-Observability
- Local-Llm
- Maci
- Math
- Mcp
- Memory
- Metadata
- Mev
- Moa
- Model-Routing
- Moe
- Mpp
- Mtp
- Multi-Agent
- Observability
- Okf
- Onchain
- Open-Source
- Open-Standard
- Opik
- Orderbook
- Passkey
- Physical-Ai
- Platforms
- Post-Quantum-Cryptography
- Post-Training
- Privacy
- Prompt-Engineering
- Provenance
- Python
- Qbft
- Quant-Finance
- Quantum-Computing
- Qwen
- Rag
- Reasoning
- Reinforcement-Learning
- Render
- Reputation
- Retrieval
- Reverse-Kl
- Rl
- Robot-Learning
- Rwa
- Search-Agent
- Security
- Self-Improvement
- Semaphore
- Settlement
- Skills
- Small-Language-Model
- Smart-Contract
- Smart-Contracts
- Smolvla
- Snark
- Software
- Solidity
- Sp1
- Stablecoin
- Stigmergy
- Swe-Bench
- Tokenization
- Tracing
- Trading
- Tutorial
- Ucp
- Uncensored
- Usdc
- Validators
- Vla
- Voting
- Wallet
- Webauthn
- X402
- Ylds
- Zero-Knowledge
- Zk-Proof
- Zk-Rollup