Eval 없는 Agent Skill은 배포하지 마라: Philipp Schmid의 스킬 테스트 방법론과 SkillsBench
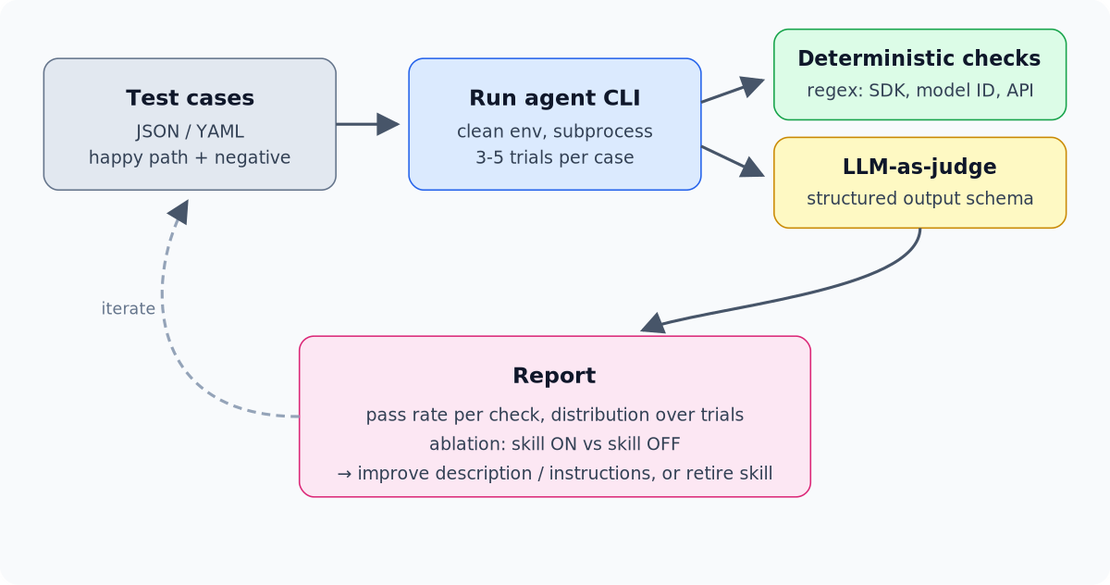
Claude Code, Gemini CLI, Codex 같은 코딩 에이전트를 쓰다 보면 자연스럽게 스킬(Agent Skill)을 만들게 된다. 사내 코딩 컨벤션, 특정 SDK 사용법, 배포 절차 같은 지식을 Markdown 파일로 정리해 에이전트에게 물려주는 방식이다. 문제는 거의 아무도 이 스킬을 테스트하지 않는다는 점이다. 코드는 테스트 없이 배포하지 않으면서, 에이전트의 행동을 바꾸는 스킬은 몇 번 돌려 보고 “괜찮네” 수준의 감으로 배포한다.
더 보기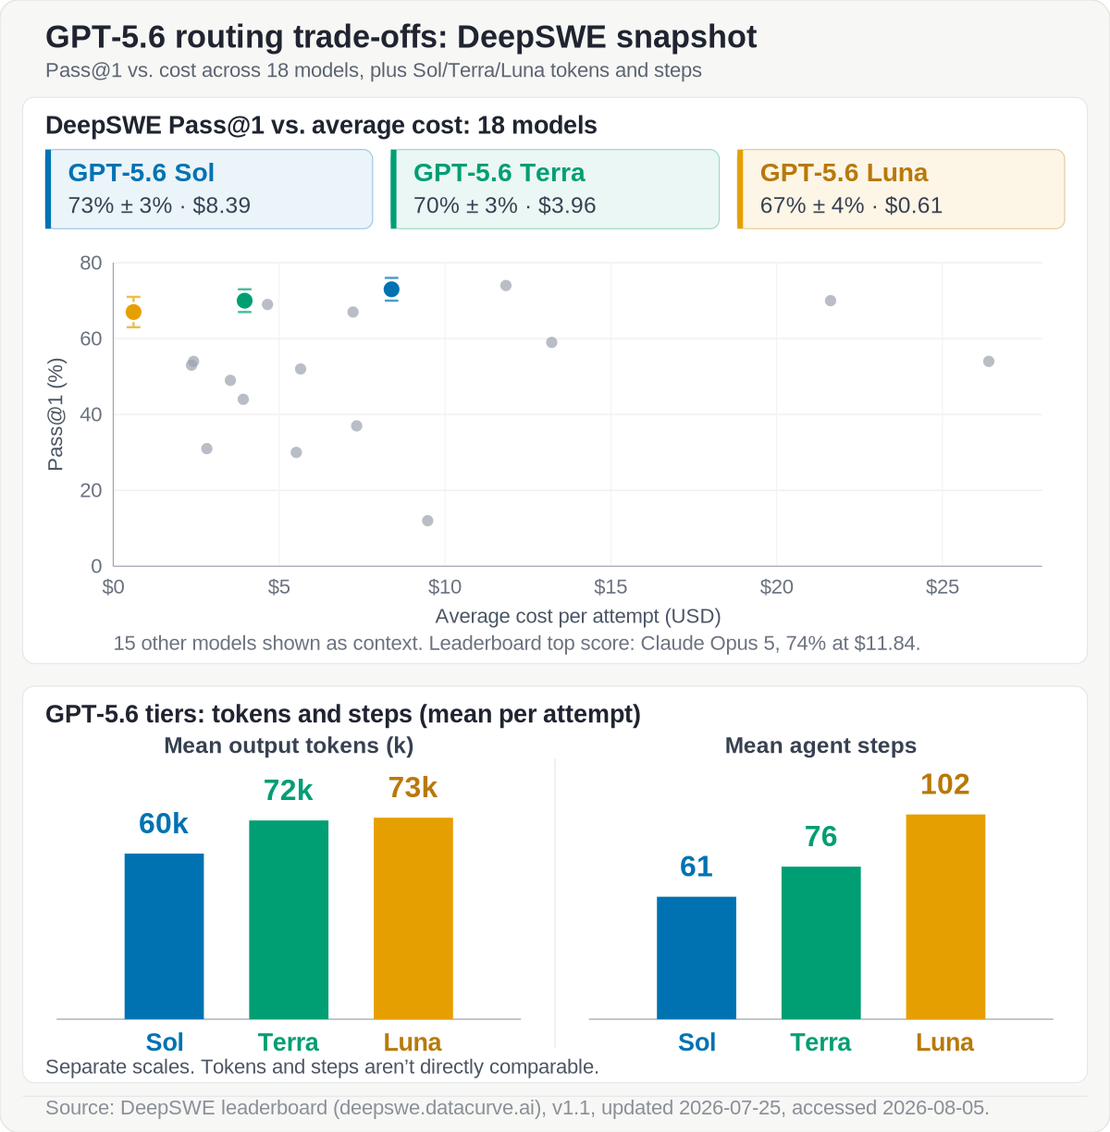
GPT-5.6 Sol·Terra·Luna 코딩 에이전트 모델 선택 가이드
GPT-5.6 이야기를 하다 보면 “Luna Max가 Terra High보다 낫다더라” 식의 서열이 자주 돌아다닙니다. 이 문장은 애초에 성립하지 않는 비교입니다. Sol·Terra·Luna는 서로 다른 모델(능력 티어)이고, max·high·xhigh·ultra는 같은 모델 안에서 얼마나 오래 생각하고 얼마나 많은 에이전트를 병렬로 굴릴지 정하는 설정입니다. 티어와 설정을 한 줄로 섞어 서열화하면 비교 축이 다른 값을 나란히 놓는 셈입니다.
더 보기
AI 자기개선은 모델 밖 하네스에서 먼저 온다
모델 가중치를 그대로 둬도 AI 에이전트는 실행 기록을 바탕으로 다음 작업을 더 잘하도록 바뀔 수 있습니다. 실패 원인을 찾아 프롬프트·메모리·도구·실행 절차를 수정하고, 별도 평가를 통과한 변경을 다음 실행에 남기는 방식입니다. 하네스 자기개선의 핵심은 재시도 횟수가 아니라, 검증한 변경이 축적된다는 데 있습니다. Darwin Gödel Machine(DGM)은 코딩 에이전트의 코드를 바꾸는 사례이고, GEPA와 Reflexion은 각각 프롬프트와 메모리를 바꾸는 사례입니다. 세 방법 모두 모델을 다시 학습하는 것과 구분됩니다. (DGM, GEPA, Reflexion)
더 보기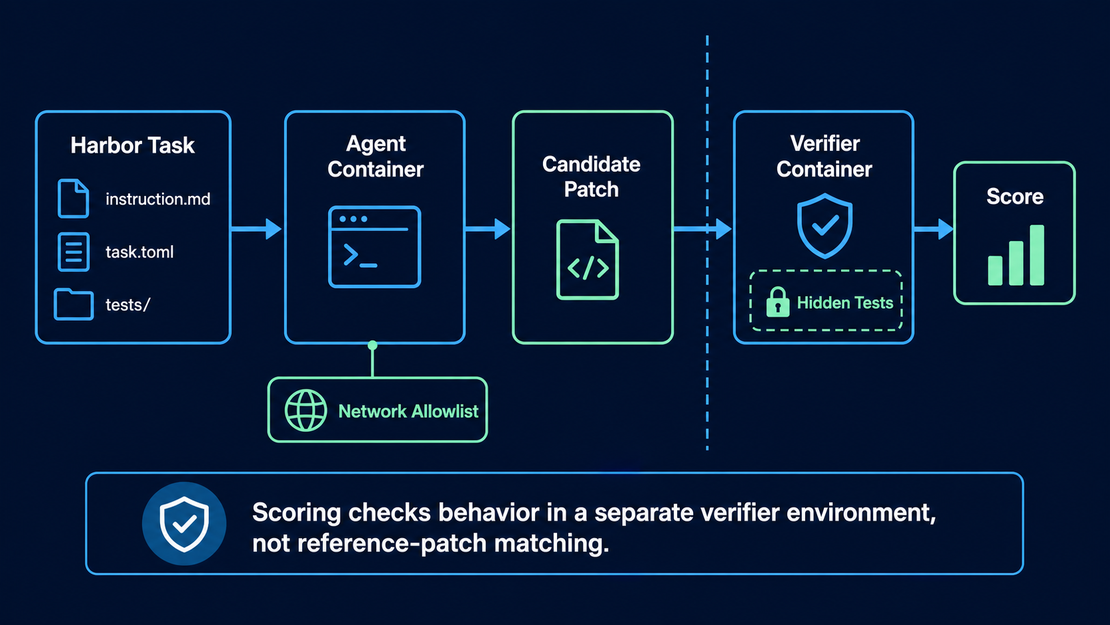
DeepSWE: 코딩 에이전트를 장기 과제로 평가하는 벤치마크
코딩 에이전트를 평가할 때 SWE-bench가 오랫동안 기준이었습니다. 그런데 SWE-bench의 태스크 대부분은 단일 파일 버그 수정이고, 정답이 이미 공개 커밋에 있습니다. 에이전트가 모델 학습 데이터에서 본 답을 그대로 재현하는 건지, 진짜로 코드를 이해하고 고치는 건지 구분하기 어렵습니다.
더 보기태그
- A2a
- Act
- Agent
- Agent-Debate
- Agent-Finance
- Agent-Harness
- Agent-Skills
- Agentic-Payments
- Ai-Agent
- Ai-Agents
- Ai-Architecture
- Ai-Blockchain
- Ai-Research
- Ai-Search
- Ai-Security
- Akash
- Anthropic
- Apify
- Base
- Benchmark
- Besu
- Bitcoin
- Bittensor
- Block-Access-Lists
- Canton
- Capital-Markets
- Ccip
- Cctp
- Chainlink
- Circle
- Coding
- Coding-Agent
- Coinbase
- Commerce
- Competition
- Compliance
- Context-Engineering
- Cross-Chain
- Cryptography
- Daml
- Data
- Data-Enclosure
- Data-Licensing
- Decentralized-Compute
- Depin
- Dex
- Diffusion-Policy
- Distillation
- Eip
- Eip-2780
- Eip-3009
- Eip-8037
- Eip-8038
- Emergent-Behavior
- Ensemble
- Enterprise-Blockchain
- Epbs
- Erc-8001
- Erc-8004
- Erc-8041
- Erc-8126
- Erc-8183
- Erc-8196
- Erc-8226
- Ethereum
- Evals
- Evaluation
- Evm
- Execution-Client
- Fhe
- Fido2
- Fintech
- Gas
- Glamsterdam
- Goldman-Sachs
- Google-Cloud
- Gpt-5-6
- Groth16
- Harness
- Heloc
- Hermes-Agent
- Identity
- Imitation-Learning
- Institutional-Finance
- Kimi
- Knowledge-Management
- Kya
- Langfuse
- Langgraph
- Lerobot
- Llama-Cpp
- Llm
- Llm-Agents
- Llm-as-Judge
- Llm-Observability
- Local-Llm
- Maci
- Math
- Mcp
- Memory
- Metadata
- Mev
- Moa
- Model-Routing
- Moe
- Mpp
- Mtp
- Multi-Agent
- Observability
- Okf
- Onchain
- Open-Source
- Open-Standard
- Opik
- Orderbook
- Passkey
- Physical-Ai
- Platforms
- Post-Quantum-Cryptography
- Post-Training
- Privacy
- Prompt-Engineering
- Provenance
- Python
- Qbft
- Quant-Finance
- Quantum-Computing
- Qwen
- Rag
- Reasoning
- Reinforcement-Learning
- Render
- Reputation
- Retrieval
- Reverse-Kl
- Rl
- Robot-Learning
- Rwa
- Search-Agent
- Security
- Self-Improvement
- Semaphore
- Settlement
- Skills
- Small-Language-Model
- Smart-Contract
- Smart-Contracts
- Smolvla
- Snark
- Software
- Solidity
- Sp1
- Stablecoin
- Stigmergy
- Swe-Bench
- Tokenization
- Tracing
- Trading
- Tutorial
- Ucp
- Uncensored
- Usdc
- Validators
- Vla
- Voting
- Wallet
- Webauthn
- X402
- Ylds
- Zero-Knowledge
- Zk-Proof
- Zk-Rollup