TradingAgents: LLM 에이전트로 만든 트레이딩 회사, 논문과 코드 읽기
목차
TradingAgents는 여러 LLM이 자료를 분석하고 반론을 검토해 한 종목의 투자 판단과 그 근거를 만드는 연구 프레임워크입니다. 현재 코드에서는 Trader의 거래 제안을 리스크 팀이 검토한 뒤 Portfolio Manager가 최종 등급을 결정합니다. 논문의 높은 백테스트 수익률만으로 이 등급이 실거래 수익으로 이어진다고 판단할 수는 없습니다. 최신 평가 코드도 주문 체결과 계좌 잔고를 모사하지 않는다고 명시합니다. 최종 결정 코드, 평가 코드
연구 아이디어와 실행 코드를 구분하면 이 프로젝트의 용도가 선명해집니다. 논문은 전문 역할과 토론을 결합한 의사결정 구조를 제안하고 역사적 시뮬레이션을 보고합니다. 공개 코드는 그 구조를 실행하고, 중간 보고서와 최종 판단을 남깁니다. 이 글은 2026년 10월 16일(KST) 확인한 논문 v7과 최신 릴리스 v0.6.0을 기준으로 하며, 코드 링크는 커밋 1394a3f에 고정했습니다. v0.6.0 공개 시각은 2026년 10월 3일 21:30 UTC입니다. 논문, 릴리스
최종 산출물은 등급과 보고서입니다
한 번의 분석은 종목과 분석 날짜를 입력받습니다. TradingAgentsGraph.propagate()가 돌려주는 두 값은 전체 상태와 최종 등급입니다. 등급은 Buy, Overweight, Hold, Underweight, Sell의 다섯 단계입니다. 구조화된 출력을 지원하는 모델에서는 Portfolio Manager가 생성한 등급을 그대로 사용하고, 텍스트 대체 경로에서는 명시적인 Rating: 표기를 읽습니다. 해석 가능한 등급이 없으면 REVIEW를 반환합니다. 판단 불능을 Hold로 바꿔 기록하지 않기 위한 구분입니다. 반환 계약, 등급 판독
Trader가 쓰는 Buy/Hold/Sell은 중간 거래 제안입니다. 리서치 계획과, 시장 애널리스트를 선택했다면 기술적 분석 보고서의 가격 정보를 받아 진입 가격·손절 가격·포지션 크기를 제안합니다. 가격 필드는 호가 통화의 절대 가격이며, 숫자로 제시할 수 없으면 생략하도록 요청합니다. 이 제안이 최종 승인과 같지는 않습니다. Portfolio Manager가 리스크 토론을 종합해 마지막 판단을 내립니다. Trader, Portfolio Manager
save_reports()는 각 단계의 보고서와 통합 Markdown, complete_report.html을 저장합니다. 보고서에는 분석 날짜, 버전, 모델과 제공자, 선택한 애널리스트, 토론 횟수, 데이터 제공자 같은 실행 조건도 들어갑니다. 근거를 다시 읽고 오류가 생긴 단계를 찾는 데 유용하지만, 자연어 설명이 남는다는 사실 자체가 자료의 정확성이나 수익성을 검증해 주지는 않습니다. 보고서 API, 릴리스
논문과 README는 모의 거래 실행을 설명하지만, 현재 그래프의 반환 경로는 상태와 등급입니다. 특히 backtest.py는 수량·체결 가격·현금 장부가 없는 판단 품질 평가기라고 범위를 명시합니다. 따라서 분석 실행, 모의 포트폴리오 운용, 실제 브로커 주문은 별도의 기능으로 구분해야 합니다. 논문 §5, 현재 평가기의 범위
보고서를 공유하고 두 번 토론합니다
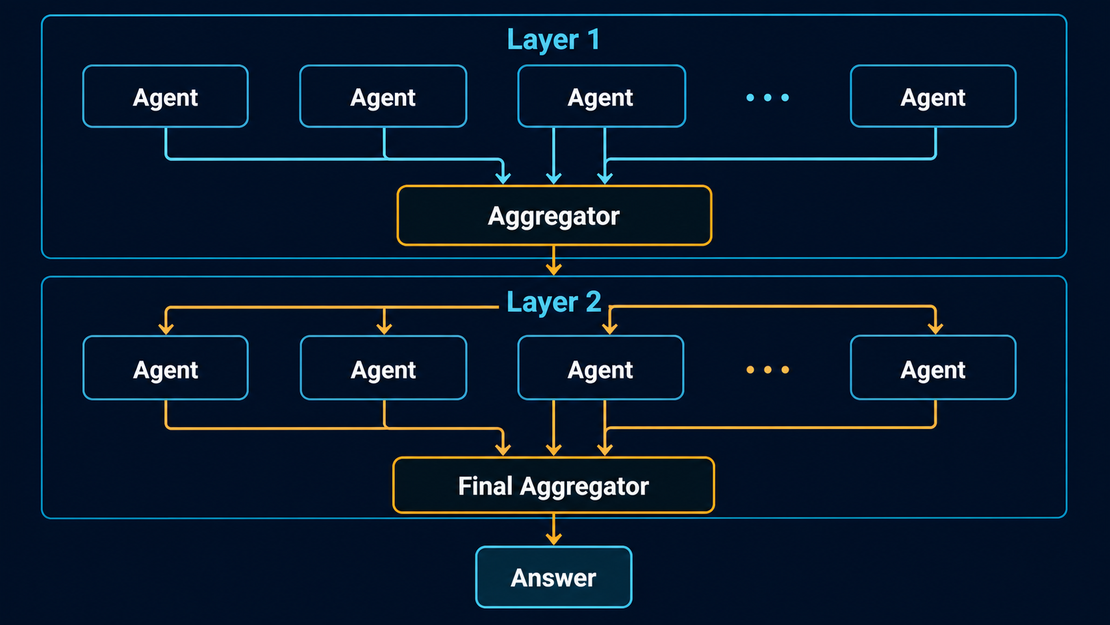
TradingAgents의 역할 분담은 자료 수집과 판단을 나눕니다. 네 애널리스트가 각자 전문 보고서를 쓰고, 강세·약세 리서처가 같은 보고서를 두고 논쟁합니다. Research Manager가 투자 계획을 정리하면 Trader가 거래 제안으로 구체화하고, 세 리스크 관점이 이를 다시 검토합니다. 논문 §§3~4, 그래프 구성
| 단계 | 입력과 역할 | 다음 단계에 남기는 내용 |
|---|---|---|
| 애널리스트 | 시장 가격·기술 지표, 소셜 심리, 뉴스·거시 지표, 기업 재무를 각각 분석 | 영역별 보고서 |
| Bull / Bear Researcher | 애널리스트 보고서로 투자 찬성·반대 논거를 주고받음 | 토론 기록 |
| Research Manager | 양측의 논거를 평가 | 투자 계획 |
| Trader | 투자 계획, 선택된 시장 보고서, 제공된 보유 자산 정보를 검토 | 거래 제안 |
| 리스크 토론 | 공격적·보수적·중립적 관점에서 거래 제안을 검토 | 리스크 토론 기록 |
| Portfolio Manager | 투자 계획·거래 제안·리스크 토론과 과거 교훈을 종합 | 최종 등급과 판단 근거 |
현재 코드는 선택한 애널리스트를 병렬로 실행합니다. 각 애널리스트의 하위 그래프는 자기 메시지 기록과 도구를 사용하고 자기 보고서만 반환합니다. 모든 보고서와 함께 실행되는 메모리 단계가 끝나야 강세·약세 토론이 시작됩니다. 토론 이후의 판단 단계는 정해진 순서로 진행합니다. 여러 에이전트라는 이유로 전체 과정이 동시에 실행되는 것은 아닙니다. 병렬 실행과 합류 조건
공유 상태에는 보고서·투자 계획·토론 기록이 별도 필드로 남습니다. 논문이 말하는 구조화된 소통은 모든 문장을 숫자나 엄격한 스키마로 바꾼다는 뜻이 아닙니다. 필요한 보고서를 상태에서 읽고, 토론은 자연어로 진행한 뒤 그 기록도 상태에 저장하는 방식입니다. 긴 대화 하나에 모든 정보를 쌓는 부담을 줄이려는 설계입니다. 다만 같은 잘못된 자료를 여러 역할이 공유하면 오류도 함께 이어질 수 있습니다. 역할을 나눴다는 사실만으로 독립적인 검증자가 생기지는 않습니다. 논문 §4, 실행 코드
토론은 설정한 횟수에서 종료됩니다. 기본값은 강세·약세가 각각 한 차례 발언하는 연구 토론과 세 리스크 관점이 각각 한 차례 발언하는 리스크 토론입니다. 코드는 각각 2 × max_debate_rounds, 3 × max_risk_discuss_rounds에서 매니저에게 넘깁니다. 애널리스트는 기본 20회의 도구 호출 라운드에 이르면 확보한 자료로 보고서를 쓰도록 요청받습니다. 이는 전체 도구 호출 수 20개라는 뜻은 아닙니다. 종료 조건, 도구 반복 제한
모델 배정도 실험 조건입니다. 현재 기본 설정의 quick_think_llm은 gpt-6-luna, deep_think_llm은 gpt-6-sol입니다. 애널리스트·리서처·Trader·리스크 토론은 quick 모델, 두 매니저는 deep 모델을 사용하며, 두 계층의 제공자도 따로 지정할 수 있습니다. 이 값은 저장소의 기본 설정이며, 논문 §4.3에서 설명한 GPT-4o 계열과 o1-preview 구성을 그대로 재현하는 설정은 아닙니다. 현재 기본값, 역할별 모델 배정, 논문 §4.3
데이터의 기간보다 공개된 시점이 중요합니다
역사적 분석에서 필요한 조건은 “자료가 과거 날짜를 다룬다”보다 엄격합니다. 그 결정을 내리는 시점에 이미 공개된 자료여야 합니다. 예를 들어 회계연도가 끝났어도 보고서를 아직 제출하지 않았다면 그 재무 수치는 당시 사용할 수 없습니다. 이후 정정된 수치를 과거 분석에 넣는 것도 결과를 미리 알려주는 효과를 냅니다. 현재 코드는 이런 시점 문제를 데이터 종류별로 다룹니다. 날짜 규칙, SEC EDGAR 구현
| 자료 | 현재 코드의 처리 | 남는 조건 |
|---|---|---|
| SEC EDGAR 재무제표 | 분석일까지 제출된 수치와 당시 이용 가능한 정정본을 선택 | SEC 제출 기업과 제공되는 공시 이력에 한정 |
| Yahoo·Alpha Vantage의 현행 기업 정보, 제출일 없는 재무제표·내부자 거래 | 과거 날짜 분석에서는 제공을 보류 | 현재 값으로 빈칸을 채울 수 없음 |
| 뉴스·Reddit·StockTwits | 게시 시각을 분석 기간으로 제한하고 과거 구간의 날짜 불명 자료를 제외 | 최근 피드가 과거 전체 기록을 제공하는 것은 아님 |
| FRED 거시 지표 | 관측 기간뿐 아니라 당시 공개본(vintage)도 지정 | 이후 수정된 값을 소급해서 쓰지 않도록 제한 |
| Polymarket 확률 | 과거 시점의 확률을 제공하지 못하므로 과거 분석에 보류 | 현재 확률을 과거의 예측값으로 사용할 수 없음 |
이 표의 근거는 공통 날짜 규칙, SEC EDGAR, FRED, Polymarket입니다. 기본 재무제표 제공자 순서는 sec_edgar,yfinance입니다. README는 EDGAR의 기계 판독 공시가 2009년부터 시작하며 초기 자료는 부족할 수 있다고 설명합니다. 비미국 시장까지 모두 같은 깊이로 과거 재무제표를 제공한다는 뜻은 아닙니다. 설정, 자료 범위
뉴스가 검색되지 않았을 때도 해석이 갈립니다. 피드가 해당 기간까지 거슬러 올라가지 못했다면 “뉴스가 없었다”가 아니라 “그 기간의 자료를 제공하지 못했다”입니다. 공통 coverage_gap()은 이 차이를 표시하고, 데이터 라우터는 설정한 제공자 순서 안에서 대체 경로를 시도합니다. 날짜 필터가 있어도 원문 아카이브가 없으면 같은 입력을 다시 확보할 수 없습니다. 기간 공백 처리, 제공자 라우팅
이 보호 장치에도 시간 단위의 한계가 있습니다. 게시물 필터의 상한은 분석 날짜 다음 날 0시(UTC) 전까지입니다. 코드에서 추론하면 분석일의 UTC 하루 전체가 포함되므로, 이를 그대로 “그날 장 시작 직전의 정보”라고 볼 수 없습니다. 장 시작 시점의 전략을 평가하려면 의사결정 시각과 거래소 시간대, 그 시각 이후에 가능한 체결을 별도로 정의해야 합니다. 시각 비교 구현
도구의 날짜 제한과 모델의 사전 지식도 별개입니다. 과거 기사와 시세를 학습한 모델은 도구가 미래 자료를 주지 않아도 사건의 결과를 알고 있을 가능성이 있습니다. 이 논문의 실험에서 그런 오염이 실제로 발생했다고 확인된 것은 아닙니다. 다만 날짜 필터만으로 그 가능성까지 제거했다고 판단할 근거도 없습니다.
논문의 수익률은 제한된 실험의 보고값입니다
논문 v7의 시뮬레이션 기간은 2024년 1월 1일부터 3월 29일까지입니다. §5는 여러 대형 기술주와 가격·뉴스·소셜·재무·종목별 60개 기술 지표를 설명하며, Table 1은 AAPL·GOOGL·AMZN의 결과를 제시합니다. 비교 대상은 Buy and Hold, MACD, KDJ+RSI, ZMR, SMA입니다. 표의 세 종목을 데이터셋 전체와 혼동하면 안 됩니다. 논문 §5와 Table 1
| 종목 | 누적 수익률 CR | 표의 연환산 수익률 ARR | Sharpe Ratio | 최대 낙폭 MDD |
|---|---|---|---|---|
| AAPL | 26.62% | 30.5% | 8.21 | 0.91% |
| GOOGL | 24.36% | 27.58% | 6.39 | 1.69% |
| AMZN | 23.21% | 24.90% | 5.60 | 2.11% |
위 값은 Table 1의 TradingAgents 행을 옮긴 저자 보고값입니다. 같은 표에서 가장 높은 베이스라인 누적 수익률은 각각 2.05%, 7.78%, 17.1%입니다. 따라서 저자가 관찰한 차이는 크지만, 이 비교만으로 토론 단계의 효과나 다른 시장 구간의 성능까지 분리해 입증한 것은 아닙니다. Table 1
수치의 내부 일관성도 확인할 필요가 있습니다. 부록 S1.2의 연환산 공식은 (최종 가치 / 초기 가치)^(1/N) - 1이며 N은 연 단위 기간입니다. 기간을 정확히 0.25년으로 가정하면 AAPL의 누적 수익 26.62%에서 계산되는 값은 약 157.05%입니다. 표의 30.5%와 맞지 않습니다. 이 계산은 표를 새 성과 수치로 대체하려는 것이 아니라, 명시된 기간·공식·표 사이에 설명이 더 필요하다는 점검입니다. ARR 열을 기대 연수익률로 읽기 어렵습니다. 부록 S1.2
Sharpe Ratio 8.21도 짧은 관측 구간과 함께 읽어야 합니다. 저자들은 최고값이 자신들의 경험적 예상 범위를 넘었다고 인정하며, 해당 기간에 하락 구간이 적었던 점을 원인으로 봅니다. 같은 주석은 예측 한 번에 LLM 11회, 도구 20회 이상의 호출이 필요해 실험을 3개월로 제한했다고 설명합니다. 이 숫자는 논문의 작업량이며, 현재 버전의 실행당 비용이나 호출 수를 측정한 값은 아닙니다. 논문 §6.1.2 주석
실거래 성과로 확대하려면 수수료·슬리피지·체결 시점·지연을 반영한 평가가 필요합니다. 논문의 실험 설명과 지표 정의만으로는 그 조건을 충분히 재현하기 어렵습니다. 논문 결론도 라이브 환경 배포와 실시간 데이터 확장을 향후 과제로 둡니다. 그러므로 이 표는 특정 실험에서 얻은 비교 결과로 다루는 것이 타당하며, 현재 코드의 실거래 능력이나 비용 차감 후 수익을 입증하는 자료가 되지는 않습니다. 논문 §§5, 7
다시 평가할 때 고정할 조건
현재 backtest는 날짜와 종목의 격자에서 같은 파이프라인을 실행하고, 등급별 표본 수·방향 적중률·평균 벤치마크 초과 수익을 집계합니다. 기본 평가 기간은 분석일 이후 5거래일입니다. Hold에는 방향 적중률을 부여하지 않고 REVIEW는 점수에서 제외합니다. 각 셀은 독립적이며, 보유 자산 정보를 주더라도 같은 장부를 매 셀에 전달할 뿐 앞선 거래로 잔고를 갱신하지 않습니다. 따라서 논문 포트폴리오 수익률의 재현기로 해석하면 안 됩니다. 평가 구현, 기본 기간
메모리는 다음 판단의 입력도 바꿉니다. 분석과 함께 실행되는 메모리 단계는 보유 기간이 지난 과거 판단의 종목 수익과 지역별 벤치마크 대비 초과 수익을 계산하고 짧은 회고를 만듭니다. Portfolio Manager는 같은 종목의 최근 판단과 다른 종목의 교훈을 읽습니다. 과거 날짜 실행에는 결과가 그 날짜까지 알려진 항목만 전달합니다. 이는 프롬프트 맥락의 갱신이며, 모델 가중치를 학습시키거나 회고의 유효성을 입증한 절차는 아닙니다. 메모리 단계, 과거 맥락 필터, 결과 계산
아래 예는 시장·뉴스 애널리스트만 선택하고 최종 등급과 판단 근거를 읽습니다. 실행하면 LLM과 데이터 API를 호출하고 로컬 기록을 남기며, save_reports()가 보고서를 저장합니다. 공식 사용법
from tradingagents.default_config import DEFAULT_CONFIG
from tradingagents.graph.trading_graph import TradingAgentsGraph

config = DEFAULT_CONFIG.copy()
config["max_debate_rounds"] = 1
ta = TradingAgentsGraph(selected_analysts=["market", "news"], config=config)
state, rating = ta.propagate("AAPL", "2026-09-01")
print(rating)
print(state["final_trade_decision"])
ta.save_reports(state, "AAPL")
같은 날짜를 입력하는 것만으로 재현 조건이 고정되지는 않습니다. 비교 실험에는 코드 SHA, 모델의 정확한 식별자와 제공자, 추론·샘플링 설정, 애널리스트 선택, 토론·도구 제한, 데이터 원문과 공개 시각, 메모리 초기 상태를 함께 보관하는 편이 좋습니다. 보고서의 run_settings는 일부 조건을 남기지만 원문 피드 전체를 보관하지 않으며, 평가 코드도 셀당 모델 샘플 한 번이라는 한계를 명시합니다. 반복 실행의 분산과 누락·실패 셀까지 기록해야 평균값을 해석할 수 있습니다. 실행 조건 기록, 평가 요약의 한계
비용은 선택한 모델, 도구 반복, 토론 길이, 재시도, 과거 판단의 회고 작업에 따라 달라집니다. 병렬 애널리스트는 대기 시간을 줄일 수 있지만 각 호출의 청구가 사라지는 것은 아닙니다. 현재 기본 모델로 실행한 요금 측정 없이 논문의 호출 수를 달러 비용으로 환산할 수 없습니다. TradingAgents를 연구 도구로 사용할 때 유용한 비교는 같은 자료와 예산에서 단일 에이전트보다 판단이 나아지는지, 어떤 반론이 최종 결정을 바꾸는지입니다. 그 답에는 읽을 수 있는 보고서와 별개로 통제된 평가가 필요합니다.
함께 보면 좋을 자료
- 논문 v7 전체: 역할 분담과 실험 방법, 표, 지표 정의를 함께 확인할 수 있습니다.
- 현재 평가기 소스: 판단별 평가와 포트폴리오 시뮬레이션의 경계가 명시돼 있습니다.
- 공통 날짜 규칙: 분석 날짜, 게시 시각, 자료 공백을 구분하는 구현입니다.
참고 자료
- TradingAgents: Multi-Agents LLM Financial Trading Framework v7: Yijia Xiao 외, 2025-06-03 개정, 조회일 2026-10-16 KST.
- TauricResearch/TradingAgents 고정 소스: Apache-2.0, 커밋
1394a3f72aa4393e1a98f51b382434c4b4c2d972, 조회일 2026-10-16 KST. - TradingAgents v0.6.0: 공식 릴리스, 2026-10-03 UTC 공개, 조회일 2026-10-16 KST.