Robot Learning: A Tutorial (고전 로보틱스에서 VLA까지)
목차
로봇 학습을 시작한다면, 한 작업을 사람이 원격 조작해 시연하고 ACT 같은 모방 학습 정책을 훈련한 뒤 같은 장치에서 제한된 조건으로 평가하는 경로가 합리적입니다. 고전 제어는 관절과 움직임을 다루고, 학습 정책은 관측에서 다음 행동을 고릅니다. VLA는 여기에 언어 지시와 사전학습을 더하지만, 보정·데이터 수집·실물 검증을 대신하지 않습니다. LeRobot 공식 문서도 첫 정책으로 ACT를 권장합니다.
Francesco Capuano, Caroline Pascal, Adil Zouitine, Thomas Wolf, Michel Aractingi의 Robot Learning: A Tutorial은 이 관계를 고전 로보틱스, 강화학습, 모방 학습, 범용 정책으로 연결합니다. 확인한 논문 버전은 2025년 10월 14일 제출된 v1입니다. 실행 절차는 2026년 10월 16일(KST) 확인한 LeRobot 공식 문서와 소스를 기준으로 합니다. 논문의 예제와 현재 CLI를 같은 버전으로 가정하면 안 됩니다.
제어·모방 학습·강화학습의 역할
고전 로보틱스에서 순기구학(FK)은 관절값으로 말단 위치를 계산하고, 역기구학(IK)은 원하는 말단 위치에 대응하는 관절값을 구합니다. 계획기는 경로를 정하고 피드백 제어기는 측정값과 목표값의 오차를 줄입니다. 물체의 마찰과 접촉 상태가 계속 바뀌는 작업에서는 환경 모델과 인식 처리를 직접 설계하는 비용이 커집니다. 학습은 이런 관측과 행동의 관계를 데이터로 익히는 방법입니다. 그렇더라도 로봇의 기구학, 모터 제어와 작업 공간 제약은 남습니다. 튜토리얼의 고전 로보틱스 절이 강조하는 결합입니다.
| 접근 | 학습하거나 설계하는 것 | 맞는 출발 조건 | 주요 부담 |
|---|---|---|---|
| 고전 제어·계획 | 모델, 목표, 경로, 오차 보정 규칙 | 기하와 작업 조건을 잘 정의할 수 있음 | 접촉·인식·환경 변화의 모델링 |
| 모방 학습(IL) | 시연의 관측과 행동 관계 | 사람이 원하는 행동을 반복 시연할 수 있음 | 시연 밖 상태와 복구 행동의 부족 |
| 강화학습(RL) | 상호작용으로 얻는 누적 보상을 높이는 정책 | 보상·리셋·탐색 범위를 관리할 수 있음 | 실물 시행착오, 보상 오류, 감독 비용 |
| VLA | 영상·언어·로봇 상태에서 행동을 만드는 정책 | 사전학습 모델을 자신의 장치와 작업에 적응시킬 수 있음 | 데이터·행동 표현·추론 지연의 적합성 |
VLA(Vision-Language-Action)는 입력과 모델 구조를 가리키며 IL과 RL은 학습 방법을 가리킵니다. VLA를 시연으로 미세조정하는 것도 모방 학습입니다. 이들을 서로 배타적인 네 알고리즘으로 비교하면 선택 기준이 흐려집니다.
행동 복제(Behavioral Cloning, BC)는 시연의 관측을 입력으로 받아 시연 행동을 예측하도록 지도 학습합니다. ACT와 Diffusion Policy도 이 목적을 수행하는 정책 계열입니다. BC에 별도 알고리즘을 붙이는 단계로 이해할 필요는 없습니다. RL은 상태·행동·전이·보상·할인율을 포함한 의사결정 문제에서 기대 누적 보상을 최적화합니다. 논문은 TRPO·PPO·SAC·TD-MPC 등을 설명하지만, 논문에서 다룬다는 사실이 모두 동일한 LeRobot 실물 CLI로 제공된다는 뜻은 아닙니다. 모방 학습과 강화학습의 정의는 실제 설치 기능과 구분해서 읽어야 합니다.
행동 묶음과 피드백 주기
모방 학습의 첫 난점은 데이터 분포입니다. 집게가 목표를 조금 빗나가면 시연에 없는 상태에 도달하고, 그 상태에서 다음 예측도 틀릴 수 있습니다. 이런 분포 변화와 오차 누적은 훈련 손실만으로 드러나지 않습니다. 또 사람이 같은 물체를 왼쪽이나 오른쪽으로 우회했다면, 두 행동을 하나의 평균으로 예측하는 회귀 모델은 장애물 쪽으로 향할 수 있습니다. 튜토리얼의 BC 설명은 이 두 문제를 구분합니다.
**ACT(Action Chunking with Transformers)**는 현재 영상과 관절 상태로 미래 행동 여러 개를 한 번에 예측합니다. 훈련 때 조건부 변분 오토인코더(CVAE)가 시연의 변동을 잠재 변수로 표현하고, 추론 때는 잠재 변수를 0으로 설정합니다. 원래 ACT의 temporal ensembling은 매 시점 새 행동 묶음을 예측해 같은 시각을 가리키는 예측들을 가중 평균합니다. 행동을 묶는다고 항상 모델 호출이 줄어드는 것은 아닙니다. ACT 공식 프로젝트와 LeRobot의 ACT 설명이 이 구조를 설명합니다.
Diffusion Policy는 관측에 조건화한 잡음 제거를 반복해 행동 시퀀스를 생성합니다. 서로 다른 유효 행동을 표현하는 데 적합하며, 예측한 시퀀스의 일부를 실행하고 새 관측으로 다시 계획하는 receding-horizon 제어를 사용합니다. 반복 생성에 걸리는 시간과 관측 갱신 주기를 함께 고려해야 합니다. 공식 프로젝트의 방법 설명에 근거한 특성입니다.
묶음 전체를 실행할 때까지 재관측하지 않으면 그 구간은 정책 관점에서 개방 루프가 됩니다. 예를 들어 30Hz로 실행하는 행동 30개는 1초 분량입니다. 이 계산은 특정 모델의 권장값이 아니라, 묶음 길이가 반응 지연과 연결된다는 예입니다. 저수준 관절 피드백이 계속 동작하더라도 물체가 움직였다는 새 영상 정보가 정책에 반영되는 시점은 별개입니다.
비동기 추론은 현재 묶음을 실행하는 동안 다음 묶음을 계산합니다. LeRobot의 Real-Time Chunking(RTC)은 지원하는 flow-matching 정책에서 이전 행동과 새 묶음의 겹치는 구간을 조건으로 삼아 연결을 조정합니다. 연산과 실행의 겹침, 행동의 시간 정렬이 핵심입니다. 추론이 끝났을 때 관측이 얼마나 오래됐는지, 큐에 실행할 행동이 남았는지까지 확인해야 합니다. 비동기화만으로 안전성이나 성공률을 보장하지는 않습니다.
LeRobotDataset과 장치 설정의 연결
LeRobot은 로봇 연결부터 수집·학습·추론까지 연결하는 Hugging Face의 오픈소스 라이브러리입니다. 현재 공식 LeRobotDataset v3 문서는 상태·행동·타임스탬프를 Parquet에, 카메라 영상을 MP4에 저장하고 스키마·정규화 통계·에피소드 경계를 메타데이터로 관리합니다. 여러 에피소드가 한 파일을 공유할 수 있으므로 파일 하나를 에피소드 하나로 취급하면 안 됩니다.
학습기가 보는 것은 단순한 동영상이 아닙니다. observation.state, action, observation.images.front 같은 키와 각 값의 차원·순서가 계약을 이룹니다. delta_timestamps는 기준 시각에 대한 과거 관측이나 미래 행동의 시간 창을 지정합니다. 대규모 데이터는 스트리밍으로 읽을 수 있지만, 데이터가 다른 로봇에도 의미가 있는지는 저장 형식이 해결하지 않습니다.
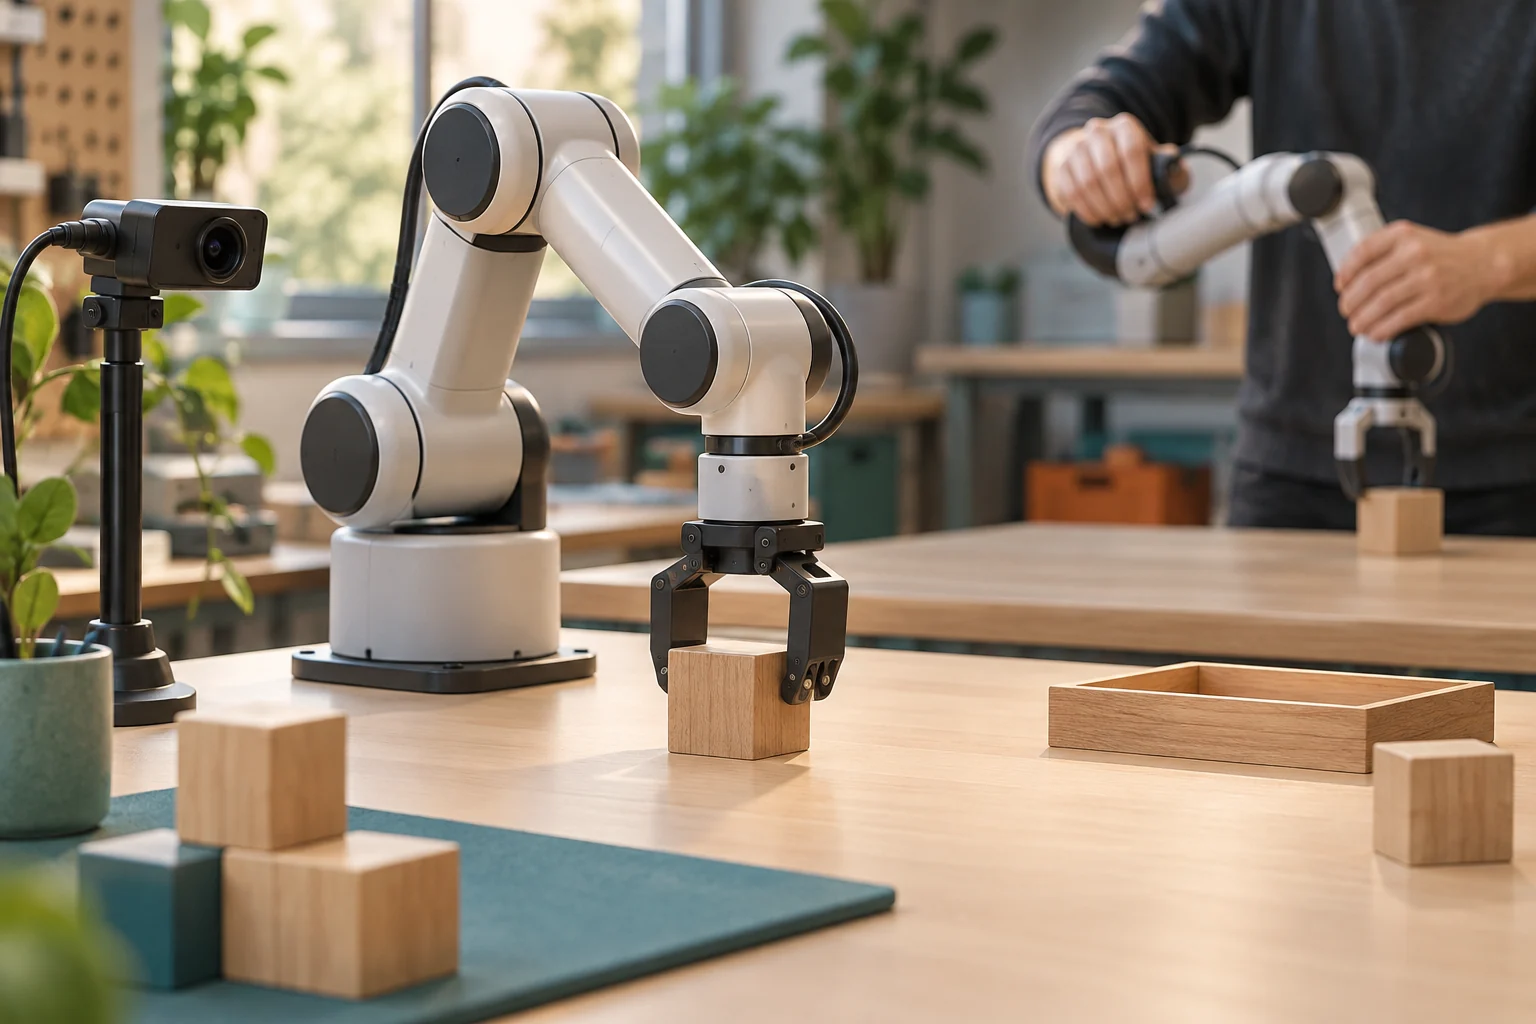
실습에는 SO-101 follower와 leader, 고정된 OpenCV 카메라 하나를 예로 듭니다. follower가 실제 작업을 수행하고 사람이 움직이는 leader가 시연 명령을 보냅니다. 다른 장치를 쓰면 해당 로봇 안내에 맞춰 타입·드라이버·보정을 바꿔야 합니다. 아래 명령은 문서와 소스를 대조한 예시이며, 이 글을 위해 실제 하드웨어에서 실행한 결과는 아닙니다.
설치와 포트·카메라 확인
별도 Python 3.12 환경과 플랫폼에 맞는 PyTorch를 준비합니다. CUDA 예시는 NVIDIA GPU와 호환 드라이버가 전제입니다. 영상 디코딩용 FFmpeg/TorchCodec의 플랫폼 조건도 설치 문서에서 확인해야 합니다. 다음 소스 설치는 확인한 커밋을 고정하며, 하드웨어·학습·Feetech 의존성을 함께 설치합니다.
git clone https://github.com/huggingface/lerobot.git
cd lerobot
git checkout 297774fca4e3ad0aa34e7425fbf937111637e77b
python -m pip install -e '.[core_scripts,training,feetech]'
lerobot-find-port
lerobot-find-cameras opencv
포트 탐색은 안내에 따라 해당 USB 연결을 분리해 장치를 식별합니다. 카메라 번호도 직접 확인합니다. 아래 FOLLOWER_PORT, LEADER_PORT, CAMERA_INDEX 값은 자신의 장치로 바꿀 자리이며, 포트를 추측해서 로봇 명령을 보내면 안 됩니다. Linux에서는 시리얼 장치 접근 권한도 필요합니다. 새 모터의 ID·baudrate 설정과 조립은 보정 이전에 SO-101 가이드대로 마쳐야 합니다.
보정 후 원격 조작
보정은 leader와 follower의 같은 자세가 일관된 관절값으로 해석되게 합니다. 장치를 움직여 범위를 읽는 절차이므로 주변을 비우고 공식 안내를 따라 수행합니다. 이후 같은 장치에서는 아래 ID를 수집과 평가까지 유지합니다. LeRobot은 ID를 보정 파일 식별에 사용합니다.
FOLLOWER_PORT=/dev/ttyACM0
LEADER_PORT=/dev/ttyACM1
CAMERA_INDEX=0
CAMERAS="{front: {type: opencv, index_or_path: ${CAMERA_INDEX}, width: 640, height: 480, fps: 30}}"

lerobot-calibrate --robot.type=so101_follower \
  --robot.port="$FOLLOWER_PORT" --robot.id=tutorial_follower
lerobot-calibrate --teleop.type=so101_leader \
  --teleop.port="$LEADER_PORT" --teleop.id=tutorial_leader

lerobot-teleoperate \
  --robot.type=so101_follower --robot.port="$FOLLOWER_PORT" \
  --robot.id=tutorial_follower --robot.cameras="$CAMERAS" \
  --teleop.type=so101_leader --teleop.port="$LEADER_PORT" \
  --teleop.id=tutorial_leader --display_data=true
여기서 팔이 예상 방향으로 움직이는지, 집게와 물체가 영상에 보이는지부터 확인합니다. 공식 수집 가이드는 카메라 영상만 보고도 사람이 작업을 수행할 수 있는 구성을 권합니다. 시연 도중 카메라를 옮기면 관측 조건도 달라집니다.
소규모 수집과 데이터 점검
다음은 저장 경로와 키를 확인하는 5개 에피소드의 시험 수집입니다. 충분한 학습 데이터라는 뜻은 아닙니다. Hub 업로드를 끄므로 로그인 없이 로컬 수집 경로를 사용합니다. example-user는 실제 계정 대신 넣은 식별자이며, 업로드할 때는 자신이 권한을 가진 저장소로 바꿉니다.
DATASET_ID=example-user/cube-pickplace
DATA_ROOT="$PWD/data/cube-pickplace"

lerobot-record \
  --robot.type=so101_follower --robot.port="$FOLLOWER_PORT" \
  --robot.id=tutorial_follower --robot.cameras="$CAMERAS" \
  --teleop.type=so101_leader --teleop.port="$LEADER_PORT" \
  --teleop.id=tutorial_leader --display_data=true \
  --dataset.repo_id="$DATASET_ID" --dataset.root="$DATA_ROOT" \
  --dataset.single_task="Put the cube in the bin" \
  --dataset.num_episodes=5 --dataset.fps=30 \
  --dataset.push_to_hub=false
저장한 에피소드에서 영상·관절 상태·행동이 맞물리는지, 물체가 가려지지 않는지, 성공과 실패 구간이 의도대로 기록됐는지 확인합니다. 공식 가이드는 첫 집기 작업에 50개 에피소드, 위치별 10개를 출발점으로 제안합니다. 이는 특정 수집 구성을 위한 권고이며 모든 작업의 최소 표본이나 성공 보장이 아닙니다. 시작 위치별 반복을 확보하고, 안정된 뒤 물체 위치와 조명 같은 변화를 하나씩 늘리는 편이 실패 원인을 구분하기 쉽습니다.
아래 코드는 같은 로컬 데이터에서 상태·행동 차원과 영상 텐서를 확인합니다. 숫자만 맞아도 관절 순서나 행동 단위가 틀릴 수 있으므로 메타데이터와 함께 봐야 합니다.
import os
from lerobot.datasets import LeRobotDataset

dataset = LeRobotDataset(
    "example-user/cube-pickplace",
    root=os.path.join(os.getcwd(), "data/cube-pickplace"),
)
sample = dataset[0]
for key in ("observation.state", "action", "observation.images.front"):
    print(key, sample[key].shape)
ACT 학습과 제한된 실물 평가
수집량과 품질을 점검한 뒤 같은 데이터 경로로 ACT를 학습합니다. 아래 10,000스텝과 batch size 8은 실행 구성을 보여 주는 값이며 수렴 기준이 아닙니다. GPU 메모리, 검증 결과와 작업에 맞게 조정합니다. 학습 결과와 데이터는 로컬에 유지합니다.
lerobot-train \
  --dataset.repo_id="$DATASET_ID" --dataset.root="$DATA_ROOT" \
  --policy.type=act --policy.device=cuda \
  --output_dir=outputs/train/act_cube --job_name=act_cube \
  --batch_size=8 --steps=10000 \
  --policy.push_to_hub=false --wandb.enable=false
저장된 체크포인트가 있는지 확인한 다음, 동일한 보정 ID와 카메라 설정으로 짧게 평가합니다. base 전략은 행동을 실행하지만 평가 영상을 자동 기록하지 않습니다. 별도 시험 기록을 남기거나 기록이 필요한 경우 공식 문서의 episodic 전략을 구성합니다. 현재 배포 CLI 소스는 lerobot-rollout을 실물 정책 실행 진입점으로 정의합니다.
lerobot-rollout \
  --strategy.type=base \
  --policy.path=outputs/train/act_cube/checkpoints/last/pretrained_model \
  --robot.type=so101_follower --robot.port="$FOLLOWER_PORT" \
  --robot.id=tutorial_follower --robot.cameras="$CAMERAS" \
  --task="Put the cube in the bin" --fps=30 --duration=10
--duration=10은 정책 실행 루프에 10초 제한을 둡니다. 설정의 기본값은 return_to_initial_position=True이며, base 종료 처리에도 이 값이 전달되므로 종료 중 시작 자세로 복귀하는 추가 움직임이 생길 수 있습니다. 이 시간 제한은 물리적 비상정지 기능이나 모든 움직임이 정확히 10초 뒤 끝난다는 보장이 아닙니다.
처음에는 사람이 즉시 중단할 수 있는 범위에서 부드러운 물체로 시험합니다. 학습 때와 같은 시작 조건을 반복한 뒤, 별도로 정한 미시연 위치에서도 평가합니다. 성공 횟수/전체 시도 수, 사람 개입, 충돌이나 낙하, 시작 위치와 사용한 체크포인트를 함께 적습니다. 같은 조건의 실패가 반복되면 학습 스텝만 늘리기보다 가림·행동 표현·관측 지연·복구 시연 부족을 먼저 점검하는 것이 실용적입니다.
VLA의 전이 능력과 적용 한계
VLA는 영상과 언어를 해석하는 사전학습 모델에 로봇 행동 생성을 결합합니다. π₀는 PaliGemma 기반 VLM과 행동 expert를 결합하며 flow matching으로 연속 행동을 생성합니다. Flow matching은 잡음과 목표 행동 사이의 이동을 나타내는 벡터장을 학습하고, 추론 때 이를 따라 행동 샘플을 생성하는 방법입니다. SmolVLA도 VLM과 행동 expert를 사용하며, 공식 모델 lerobot/smolvla_base는 자신의 데이터로 미세조정하는 출발점입니다.
이 구조는 언어·시각 사전학습을 로봇 작업에 재사용하지만, 지시문만 바꾸면 모든 팔에서 같은 작업을 수행한다는 뜻은 아닙니다. 관절 수와 순서, 절대 위치와 상대 변위의 구분, 단위, 카메라 키, 정규화 통계가 맞아야 합니다. 물체 위치를 알아보는 능력과 실제 집기의 접촉·힘 조절 능력도 동일하지 않습니다. 튜토리얼의 범용 정책 절은 로봇별 데이터의 이질성과 무분별한 혼합에 따른 negative transfer를 경고합니다.
Open X-Embodiment는 여러 로봇의 데이터를 모아 전이를 연구하고, DROID는 여러 실제 환경에서 수집한 조작 데이터를 제공합니다. 이런 데이터의 가치는 수집 규모뿐 아니라 어떤 행동 표현과 환경 분포를 포함하는지에 달려 있습니다. 자신의 장치와 다른 데이터라면 형식 변환만으로 곧바로 사용할 수 있다고 가정하면 안 됩니다.
RL을 실물에 적용할 때 필요한 조건
시연보다 나은 행동을 탐색하거나 성공 기준으로 정책을 개선하려면 RL을 검토할 수 있습니다. 다만 시뮬레이션의 마찰·접촉·센서 조건은 실물과 다르고, 실제 탐색에는 로봇 마모와 물체 재배치 비용이 듭니다. 보상이 잘못 정의되면 원하는 작업 대신 점수를 높이는 행동을 학습할 수도 있습니다. 시뮬레이션 성공만으로 실물 안전성을 판단할 수 없는 이유입니다.
LeRobot의 HIL-SERL 가이드는 사전 시연, 영상 기반 성공 판별기, 사람이 개입하는 온라인 actor와 SAC learner를 결합합니다. 사람의 교정 데이터와 실제 상호작용이 학습에 들어가며, 작업 공간 경계·리셋·성공 판별을 별도로 구성합니다. 사람 개입은 RL의 유일한 방법도, 자동 안전 인증도 아닙니다. 감독과 중단 수단을 갖춘 실물 학습 설계의 한 사례입니다.
모방 학습 평가에도 같은 물리적 주의가 필요합니다. 팔을 고정하고 케이블과 작업 공간을 정리하며, 손이나 사람이 집게와 관절 사이에 들어가지 않게 합니다. 제조사·장치가 지원하는 범위에서 속도·행동 변화량·관절 및 말단 경계를 제한하고, 전원을 안전하게 차단하는 방법을 확인합니다. 기록 프로그램의 종료 키는 물리적 비상정지 장치와 같지 않습니다. 이런 운영 권고는 학습 알고리즘과 별도로 적용해야 합니다.
첫 실험의 성패를 가르는 것은 모델 이름보다 관측과 행동의 일관성입니다. 한 작업에서 시연 수집, 데이터 점검, ACT 학습, 반복 평가가 연결돼야 VLA 미세조정이나 온라인 RL을 도입했을 때 무엇이 개선됐는지도 판단할 수 있습니다.
함께 보면 좋을 자료
- ACT와 ALOHA: 행동 묶음과 정밀 양팔 조작의 원 연구입니다.
- Diffusion Policy: 행동 분포와 receding-horizon 제어를 함께 설명합니다.
- Open X-Embodiment와 DROID: 데이터의 로봇·환경 구성을 비교할 자료입니다.
참고 자료
아래 자료는 2026년 10월 16일(KST)에 확인했습니다. 명령의 소스 기준은 LeRobot 커밋 297774fca4e3ad0aa34e7425fbf937111637e77b입니다.
- Capuano, Pascal, Zouitine, Wolf, Aractingi, Robot Learning: A Tutorial, arXiv:2510.12403v1, 2025년 10월 14일 제출.
- Hugging Face, 설치, SO-101 설정·보정, 카메라, 실물 모방 학습.
- Hugging Face, LeRobotDataset v3, ACT, SmolVLA, RTC, HIL-SERL.
- Hugging Face, 확인한 LeRobot 소스.
- Physical Intelligence, π₀ 소개.