whackur
AI, 블록체인(Web3·Solidity), 로컬 LLM, 피지컬 AI를 직접 파고들어 기록합니다.
이더리움 Glamsterdam 업그레이드: ePBS와 BAL, 전체 EIP와 달라지는 운영
- whackur
- Blockchain
- 2026년 10월 17일
Glamsterdam은 이더리움 L1의 처리 용량을 늘리기 위해 블록을 만드는 절차와 받은 블록을 검증하는 절차를 함께 바꾸는 업그레이드입니다. ePBS는 블록 제안자와 빌더 사이의 약속·공개·지급을 프로토콜 안에서 처리하고, BAL은 블록 실행 중 접근한 상태와 트랜잭션별 변경값을 전달해 수신 노드가 읽기와 검증을 병렬화하도록 돕습니다. 가스 재조정과 네트워크 개선도 이 목표를 뒷받침합니다. 다만 모든 거래의 수수료 인하나 일정한 TPS를 보장하는 변경은 아닙니다. EIP-7773이 전체 범위를, EIP-7732와 EIP-7928이 두 핵심 메커니즘을 정의합니다.
더 보기
AI 시대의 기술 해자
소프트웨어를 만드는 것과 돈을 버는 것은 다릅니다 얼마 전 AI 컨퍼런스를 다녀왔습니다. 수많은 제품과 시연을 보면서 한 가지 질문이 머릿속을 떠나지 않았습니다.
더 보기
AI 시대의 데이터 폐쇄화(Data Enclosure)와 플랫폼 독점화 동향
AI 시대의 데이터 폐쇄화는 누가 어떤 목적으로 데이터를 다시 쓸 수 있는지를 플랫폼이 정하는 문제입니다. API를 끝내는 곳도 있지만, 특정 AI 기업과 계약하거나 사용량에 따라 요금을 받는 곳도 있습니다. 아래 사례들은 접근 조건의 재편을 보여 줍니다. 이것만으로 특정 기업의 독점이나 위법 행위가 입증되지는 않습니다.
더 보기
Canton Daml로 토큰 전송하기: Solidity와 상태·권한 비교
- whackur
- Blockchain
- 2026년 10월 15일
Alice가 가진 토큰 100 단위를 Bob에게 모두 보내면, 다음에 그 100 단위를 쓸 수 있는 사람은 Bob입니다. Solidity 예제는 주소별 잔액을 갱신하고, Canton에서 실행할 Daml 예제는 Alice의 보유 계약을 소비한 뒤 Bob의 보유 계약을 만듭니다. 같은 전송 결과를 서로 다른 상태와 권한으로 표현합니다.
더 보기
Besu 이해하기: 이더리움 실행부터 은행의 토큰 결제까지
- whackur
- Blockchain
- 2026년 10월 15일
Besu는 스마트 계약을 실행하고 그 결과를 검증·저장하는 Java 기반 Ethereum 클라이언트입니다. 은행은 이 소프트웨어로 예금 토큰과 은행 간 결제 자산을 함께 처리하는 원장을 구성할 수 있습니다. Ethereum 메인넷의 실행 노드로도 쓰입니다. 어느 쪽이든 실행 기술은 공유하지만, 돈의 발행자와 원장을 확정하는 주체는 네트워크마다 달라집니다. Besu 공식 문서
더 보기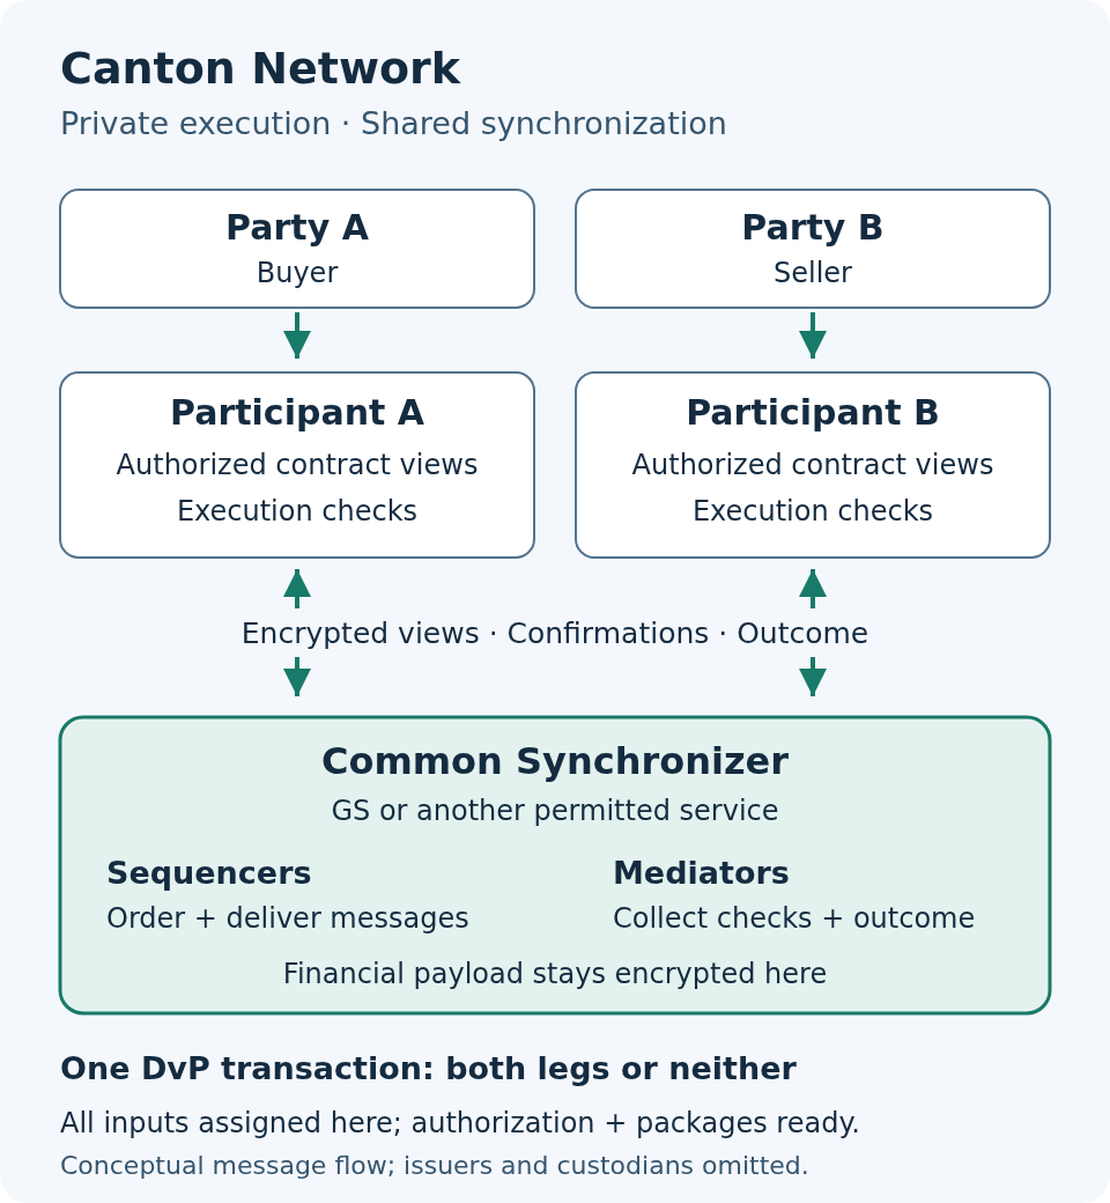
Canton Network 이해하기: 금융 프라이버시와 원자적 결제, 기관 도입 현황
- whackur
- Blockchain
- 2026년 10월 15일
증권을 산다는 행위에는 여러 원장이 관여합니다. 거래소나 거래 플랫폼에는 체결 기록이 남고, 수탁기관에는 증권 보유 기록이 남습니다. 지급을 담당하는 은행은 현금 장부를 따로 관리합니다. 서로 다른 기관이 같은 거래를 각자의 시스템에 기록하므로, 거래 후에는 금액과 권리, 처리 상태를 다시 맞추는 대사 작업이 필요합니다. 모든 기관이 하나의 공개 장부를 사용하면 단순해 보이지만 고객 잔액과 거래 전략까지 공개할 수는 없습니다.
더 보기
Glamsterdam의 새 가스 모델: EIP-8037 상태 가스, EIP-8038 접근 비용, EIP-2780 기본 가스
- whackur
- Blockchain
- 2026년 10월 15일
Glamsterdam의 세 가스 제안은 새 상태를 영구 저장하는 비용과 기존 상태를 갱신하는 비용을 올리고, 작업이 적은 일부 트랜잭션의 기본 비용을 낮춥니다. 명세상 새 콜드 스토리지 슬롯에 쓰면 실행 가스 12,100에 상태 가스 97,920이 붙고, 기존 슬롯의 트랜잭션 시작 값이 0이 아니고 콜드 상태에서 그 값과 다르게 처음 바꾸면 실행 가스 12,100이 들며 상태 가스는 들지 않습니다. 두 비용 모두 트랜잭션의 gasLimit 하나로 충당하지만 gasleft()는 별도 상태 가스 리저버를 보여 주지 않습니다. 이 숫자는 명세의 구성 비용이며 Solidity 함수 전체의 측정값이나 메인넷 적용 공지가 아닙니다. EIP-8037, EIP-8038, EIP-2780이 이 변경을 함께 정의합니다.
더 보기
Kimi 요청을 Claude로 보냈다는 앤트로픽 보고서, 왜 공개했을까
민감한 정보가 Claude에 들어오고 있었다면, 앤트로픽은 왜 그 사실을 공개했을까요. 모델 제공사에는 그 입력을 더 관측하는 이익보다 무단 이용을 줄이고 고객의 데이터 처리 문제를 알리는 이익이 더 클 수 있습니다. 경쟁사의 요청에 계속 답하면 연산 자원을 쓰면서 경쟁 모델의 학습 자료까지 만들어 주는 셈입니다. 공개는 계정 차단만으로 닿기 어려운 이용자와 기업 고객에게도 문제를 알립니다. 다만 이는 공개의 이해관계를 설명하는 추론이며, 회사 내부의 의사결정이 확인됐다는 뜻은 아닙니다.
더 보기
SwarmWorld: 말 없이 협력하는 LLM 에이전트 사회와 창작자보다 오래 남는 기술
SwarmWorld에서는 에이전트가 대화하지 않아도 다른 에이전트가 남긴 장치와 환경 변화를 관찰하며 작업을 이어갑니다. 이 공유 세계는 독립 탐색보다 여러 기능을 갖춘 기술 집합을 만드는 데 유리했지만, 최고의 단일 장치까지 보장하지는 않았습니다. MIT 연구진의 논문이 보여 준 것은 정해진 시뮬레이터 안에서 결과물이 축적되는 협력입니다. 실제 재료를 발명했거나 현실의 멀티 에이전트 시스템이 항상 더 낫다는 증거로 확대하면 실험의 뜻이 달라집니다.
더 보기
A2A(Agent-to-Agent) 프로토콜: 에이전트 간 협업 표준과 결제 레이어의 접점
- whackur
- Blockchain
- 2026년 8월 27일
A2A(Agent2Agent)는 따로 운영되는 에이전트에 일을 맡기고, 진행 상태와 결과를 받는 방법을 표준화합니다. 요청자는 Agent Card로 상대의 기능·접속 주소·인증 조건을 확인하고, 오래 걸리는 일은 Task로 추적합니다. MCP는 각 에이전트가 도구와 데이터를 사용하는 연결을 담당하며, 구매 승인이나 결제 정산은 AP2·x402 같은 별도 규약이 맡습니다. A2A로 협업하는 데 블록체인이나 지갑은 필요하지 않습니다. A2A 명세, MCP와의 역할 분담
더 보기
KYA(Know Your Agent): AI 에이전트 신원 검증, 표준 경쟁과 온체인 실태
- whackur
- Blockchain
- 2026년 8월 27일
AI 에이전트가 신원 인증서나 온체인 등록 번호를 제시해도, 그 사실만으로 결제나 데이터 접근을 허용해서는 안 됩니다. 어느 에이전트인지, 요청자가 그 신원을 통제하는지, 지금 하려는 행동을 위임받았는지, 과거 평가를 얼마나 믿을지는 서로 다른 확인입니다. KYA(Know Your Agent)는 이런 확인을 묶어 부르는 이름입니다. ERC-8004는 식별자와 공개된 신뢰 신호를 제공하고, Visa TAP이나 신원 검증 업체는 요청·조직·사람을 확인하는 다른 방식을 제공합니다. 최종 접근 결정은 서비스를 제공하는 쪽에 남습니다. ERC-8004 명세와 Trulioo의 제품 설명도 각각 등록과 검증이 보장하는 범위를 제한합니다.
더 보기
gs-quant: 골드만삭스가 퀀트 코드를 오픈소스로 공개한 방식과 그 경계
GS Quant는 내가 준비한 데이터의 시계열 계산과 금융 상품 객체 정의는 로컬에서 실행하고, Marquee의 데이터 조회·가격 평가·리스크 계산은 인증된 서비스로 요청하는 Python 툴킷입니다. 공개 코드의 Apache-2.0 라이선스와 원격 서비스·데이터를 사용할 권한은 별개입니다. 설치했다고 골드만삭스의 가격 평가 서비스를 함께 받은 것은 아니지만, 계정 없이 실행할 수 있는 분석 코드도 있습니다. 공개 소스에서 이 두 영역을 함수별로 구분해야 합니다.
더 보기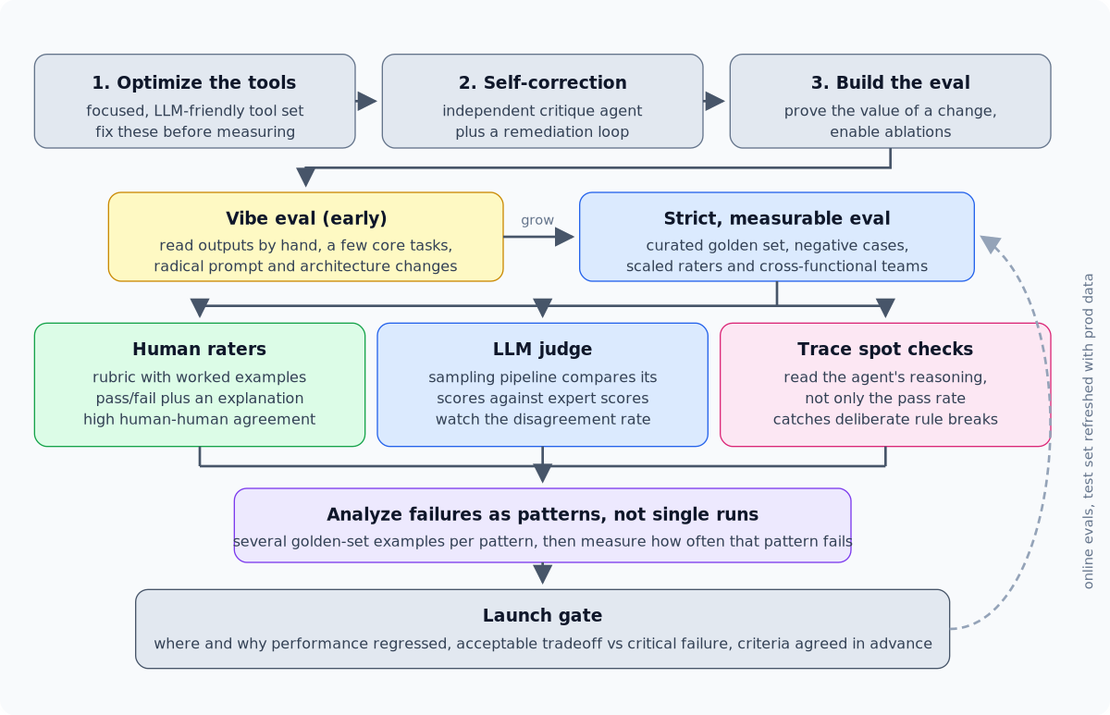
통과율만 보면 안 보이는 실패: YouTube 광고팀의 프로덕션 Eval 운영법
프롬프트를 잘 쓰면 에이전트가 말을 듣는다는 기대는 데모까지만 유효하다. 프로덕션에 올리면 같은 프롬프트, 같은 입력에도 실행마다 결과가 달라진다. 어제 통과한 케이스가 오늘 실패하고, 어제 실패한 케이스가 오늘 통과한다. 이 상태에서 “출시해도 되는가"를 판단하려면 감이 아니라 측정 장치가 필요하다.
더 보기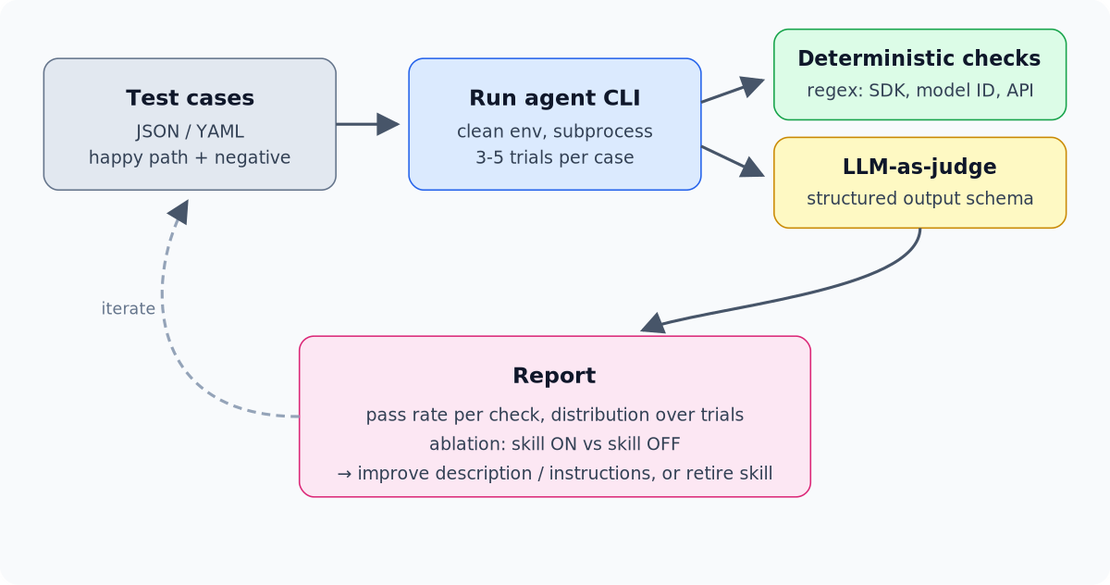
Eval 없는 Agent Skill은 배포하지 마라: Philipp Schmid의 스킬 테스트 방법론과 SkillsBench
Claude Code, Gemini CLI, Codex 같은 코딩 에이전트를 쓰다 보면 자연스럽게 스킬(Agent Skill)을 만들게 된다. 사내 코딩 컨벤션, 특정 SDK 사용법, 배포 절차 같은 지식을 Markdown 파일로 정리해 에이전트에게 물려주는 방식이다. 문제는 거의 아무도 이 스킬을 테스트하지 않는다는 점이다. 코드는 테스트 없이 배포하지 않으면서, 에이전트의 행동을 바꾸는 스킬은 몇 번 돌려 보고 “괜찮네” 수준의 감으로 배포한다.
더 보기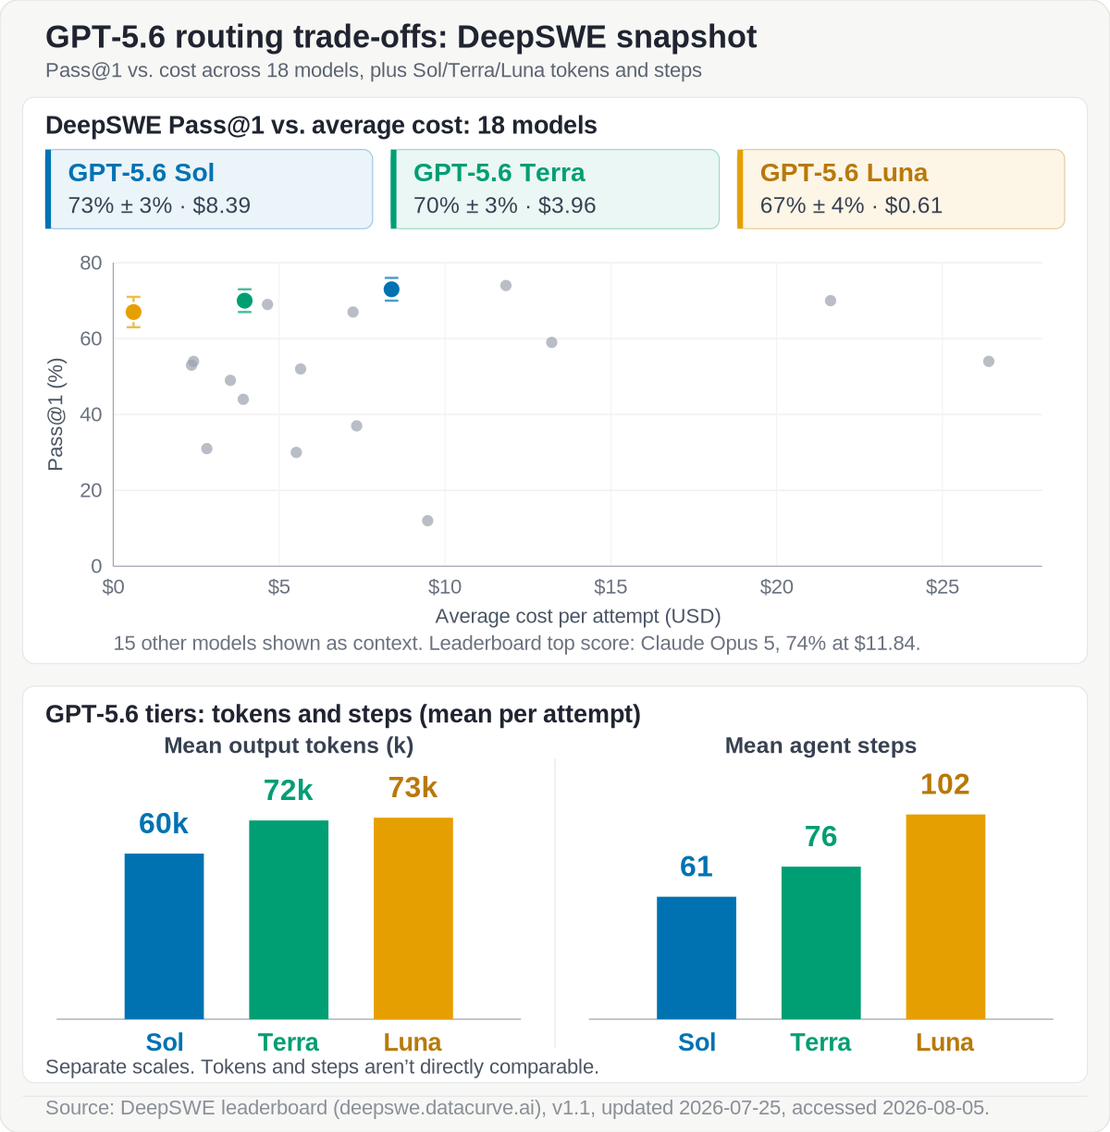
GPT-5.6 Sol·Terra·Luna 코딩 에이전트 모델 선택 가이드
GPT-5.6 이야기를 하다 보면 “Luna Max가 Terra High보다 낫다더라” 식의 서열이 자주 돌아다닙니다. 이 문장은 애초에 성립하지 않는 비교입니다. Sol·Terra·Luna는 서로 다른 모델(능력 티어)이고, max·high·xhigh·ultra는 같은 모델 안에서 얼마나 오래 생각하고 얼마나 많은 에이전트를 병렬로 굴릴지 정하는 설정입니다. 티어와 설정을 한 줄로 섞어 서열화하면 비교 축이 다른 값을 나란히 놓는 셈입니다.
더 보기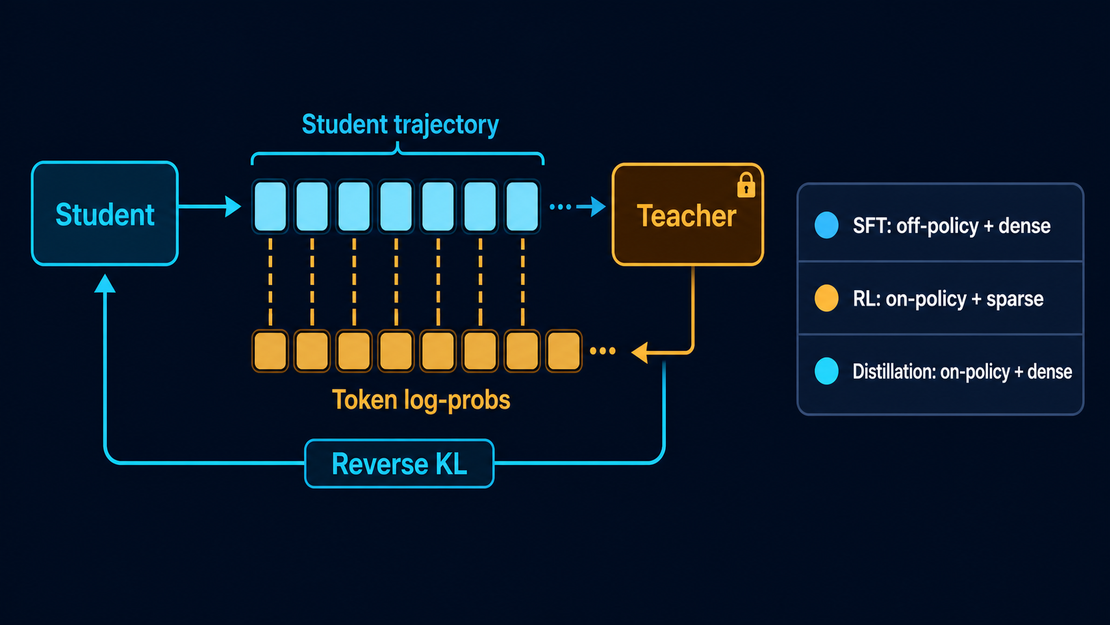
On-Policy Distillation: RL과 SFT 사이의 빈틈을 메우는 법
포스트 트레이닝에서 흔히 쓰는 두 방법에는 각자 구멍이 있습니다. SFT(supervised fine-tuning)는 교사가 만든 정답 시퀀스를 그대로 모방시키는데, 학생이 실제로 방문할 상태가 아닌 곳에서 배우다 보니 추론 단계가 길어질수록 오차가 쌓입니다. RL(강화학습)은 학생이 직접 생성한 궤적으로 배우니 이 문제는 없지만, 보상이 에피소드 하나당 한두 비트로 끝나는 경우가 많아 학습 신호가 지나치게 희박합니다. Thinking Machines Lab이 2025년 10월 공개한 글은 이 둘의 장점만 남기는 조합을 제안합니다. 학생이 스스로 궤적을 만들고, 강한 교사 모델이 그 궤적의 토큰 하나하나에 점수를 매기는 방식입니다.
더 보기
AI 자기개선은 모델 밖 하네스에서 먼저 온다
모델 가중치를 그대로 둬도 AI 에이전트는 실행 기록을 바탕으로 다음 작업을 더 잘하도록 바뀔 수 있습니다. 실패 원인을 찾아 프롬프트·메모리·도구·실행 절차를 수정하고, 별도 평가를 통과한 변경을 다음 실행에 남기는 방식입니다. 하네스 자기개선의 핵심은 재시도 횟수가 아니라, 검증한 변경이 축적된다는 데 있습니다. Darwin Gödel Machine(DGM)은 코딩 에이전트의 코드를 바꾸는 사례이고, GEPA와 Reflexion은 각각 프롬프트와 메모리를 바꾸는 사례입니다. 세 방법 모두 모델을 다시 학습하는 것과 구분됩니다. (DGM, GEPA, Reflexion)
더 보기
비트코인과 이더리움, 양자 컴퓨터는 정말 위협일까
- whackur
- Blockchain
- 2026년 7월 5일
양자 컴퓨터는 비트코인과 이더리움의 서명을 위조할 수 있는 장기적 위협입니다. 다만 2026년 10월 16일(KST) 확인한 공개 연구는 실제 secp256k1 개인키 복구 시연이 아니라, 미래의 오류 수정 양자 컴퓨터에 필요한 자원을 계산한 결과입니다. 위험을 가르는 조건은 공개키가 얼마나 오래 노출되는지, 공격 계산이 얼마나 걸리는지, 그 전에 서명과 권한을 전환할 수 있는지입니다. 비트코인의 방어안은 아직 제안 단계이고 이더리움도 계정·합의·데이터 계층을 함께 바꾸는 작업을 진행 중입니다. 자원 추정 논문, BIP-360, 이더리움 재단의 전환 계획
더 보기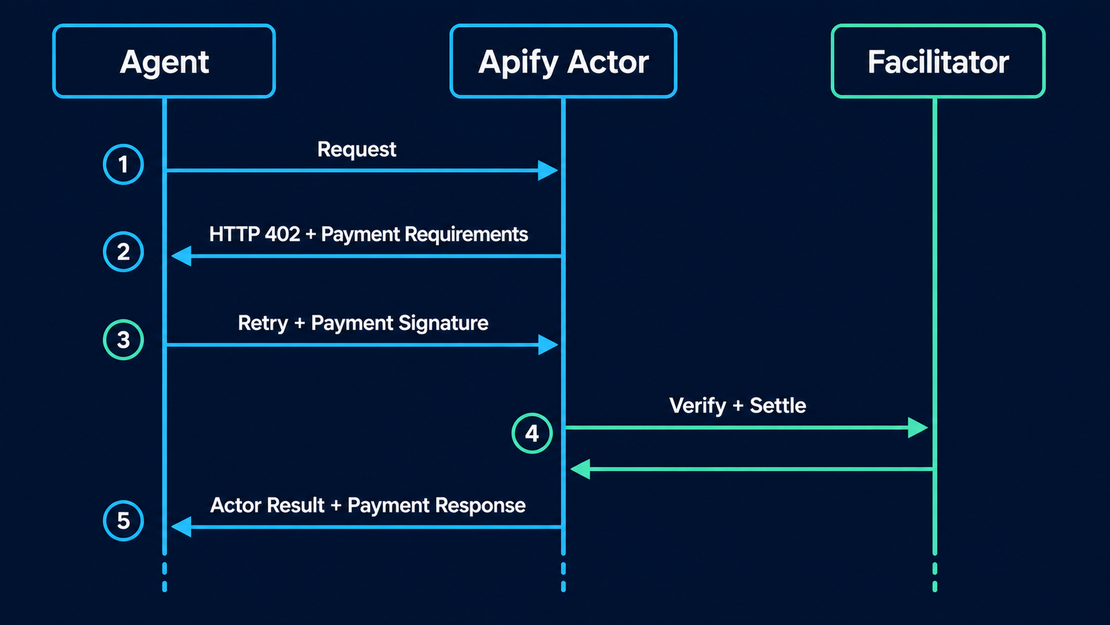
Apify x402와 Coinbase 지갑 심층편: 에이전트가 웹 자동화 도구를 직접 사는 구조
- whackur
- Blockchain
- 2026년 7월 5일
웹 스크래핑 플랫폼 Apify가 x402 결제 지원을 발표했다. AI 에이전트가 Apify 계정도 API 키도 없이 Base 체인의 USDC로 결제하고, 2만 개가 넘는 Actor를 실행할 수 있다는 내용이다. Apify는 기존 x402 생태계를 약 2,000개 엔드포인트 규모로 보고, 이번 통합으로 결제 가능한 도구 표면이 약 10배 커졌다고 설명한다.
더 보기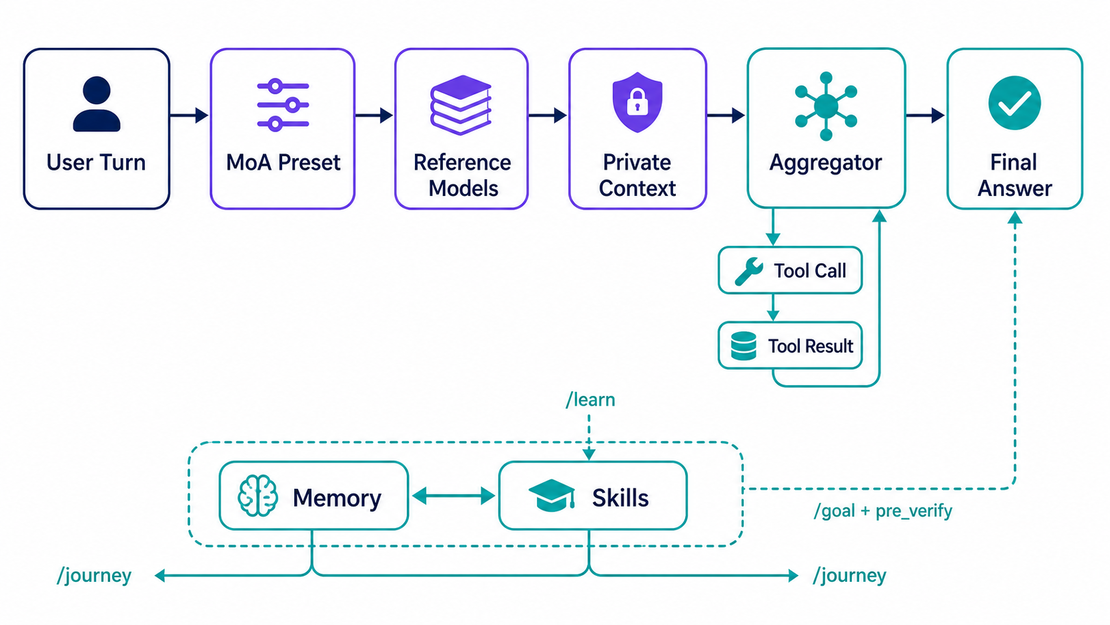
Hermes Agent v0.18: 스스로 배우는 에이전트와 MoA가 만났을 때
Nous Research가 만든 오픈소스 에이전트 Hermes Agent가 2026년 7월 1일 v0.18.0을 냈습니다. 릴리스 노트는 이번 버전을 “The Judgment Release"라고 부릅니다. 새 명령어 몇 개를 더한 마이너 업데이트로 보면 핵심을 놓치기 쉽습니다. 공식 문서는 Hermes Agent를 “스스로 배우는 AI 에이전트"라고 소개하는데, 실제로 이 프로젝트는 쓸수록 메모리와 스킬을 쌓아가는 학습 루프를 핵심 설계로 삼고 있습니다. 이 글은 그 자기개선 루프가 v0.18에서 어떻게 다듬어졌는지, 그리고 같은 버전에서 정식 모델 선택지가 된 Mixture of Agents(MoA)가 이 루프 안에서 어떤 역할을 맡는지를 정리합니다.
더 보기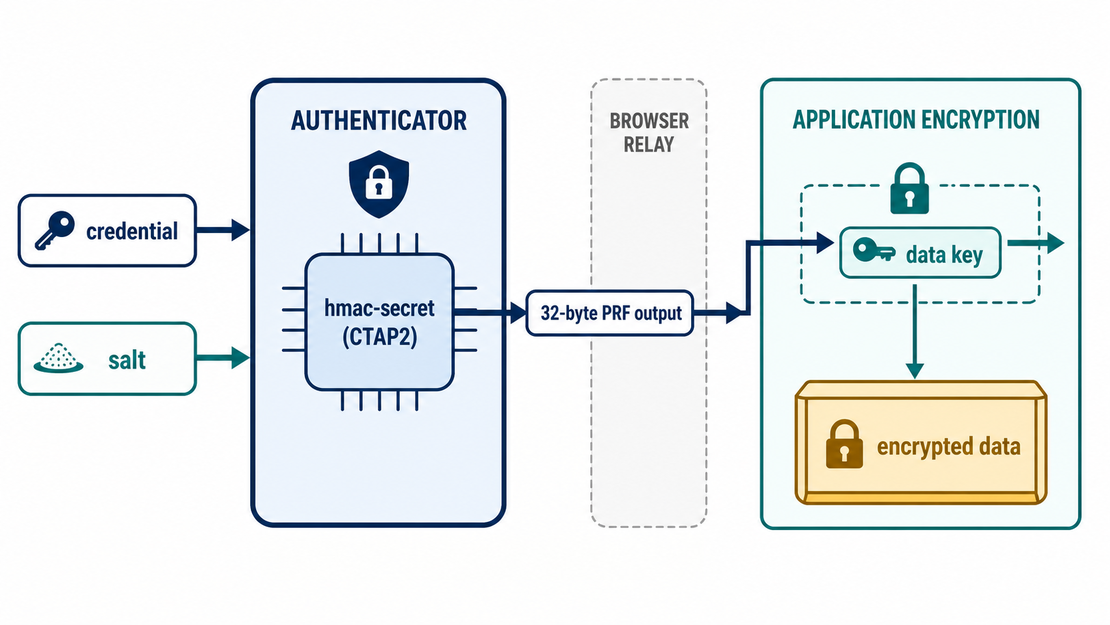
WebAuthn PRF 확장으로 passkey에서 암호화 키 꺼내기
passkey는 이제 로그인 화면에서 흔히 보이는 옵션이 됐습니다. 그런데 passkey를 쥔 authenticator에서 로그인 말고 암호화 키까지 뽑아 쓸 수 있다는 사실은 상대적으로 덜 알려져 있습니다. WebAuthn의 prf 확장이 그 통로입니다. 이 글은 PRF가 무엇을 돌려주는지, CTAP2 hmac-secret과 어떤 관계인지, 실제 암호화 설계에 넣을 때 조심해야 할 지점, 그리고 2026년 기준 기기별 지원 현황까지 정리합니다.
더 보기
TradingAgents: LLM 에이전트로 만든 트레이딩 회사, 논문과 코드 읽기
TradingAgents는 여러 LLM이 자료를 분석하고 반론을 검토해 한 종목의 투자 판단과 그 근거를 만드는 연구 프레임워크입니다. 현재 코드에서는 Trader의 거래 제안을 리스크 팀이 검토한 뒤 Portfolio Manager가 최종 등급을 결정합니다. 논문의 높은 백테스트 수익률만으로 이 등급이 실거래 수익으로 이어진다고 판단할 수는 없습니다. 최신 평가 코드도 주문 체결과 계좌 잔고를 모사하지 않는다고 명시합니다. 최종 결정 코드, 평가 코드
더 보기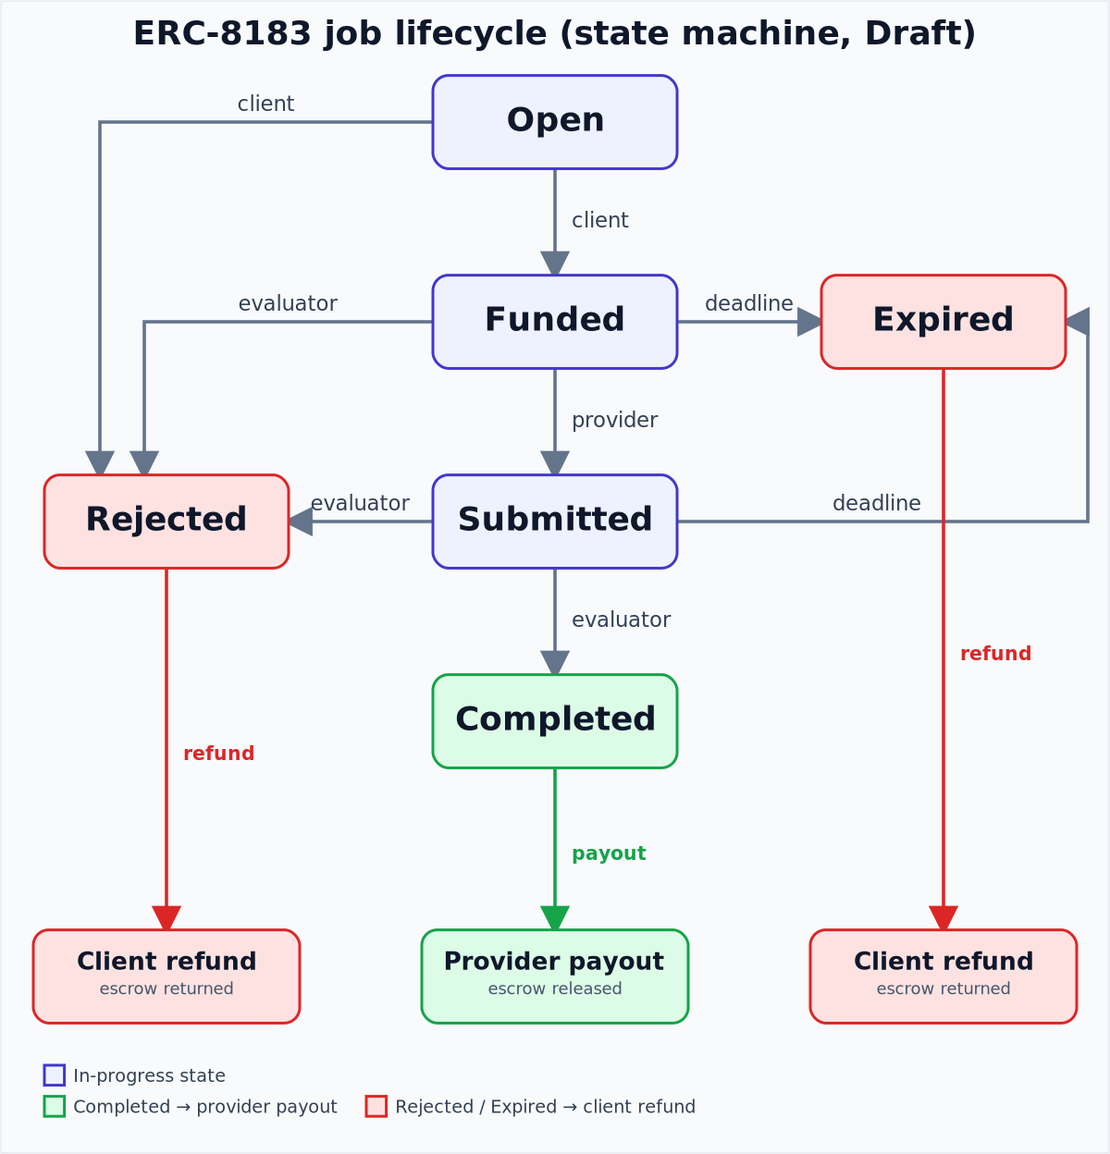
AI 에이전트 상거래와 조율: ERC-8183, ERC-8226, ERC-8001, ERC-8041
- whackur
- Blockchain
- 2026년 7월 1일
이전 글에서 다룬 ERC-8004/8126/8196은 AI 에이전트의 신원 등록, 보안 검증, 정책 실행이라는 세 계층을 정의한다. 에이전트를 식별하고, 위험도를 평가하고, 소유자가 허용한 범위 안에서만 거래를 실행하게 만드는 기반이다. 여기까지가 답하는 질문은 하나다. “이 에이전트를 믿고 내 대신 움직이게 해도 되는가.”
더 보기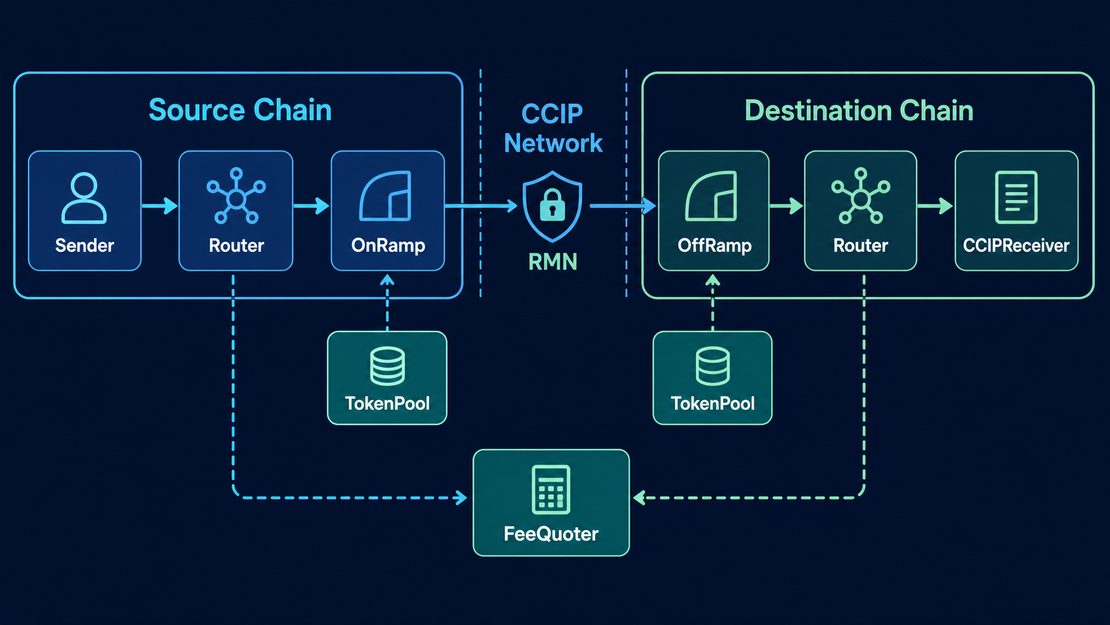
Chainlink CCIP EVM 컨트랙트 구조 분석
- whackur
- Blockchain
- 2026년 6월 30일
Ethereum Mainnet에서 Arbitrum으로 USDC를 보내거나, Polygon 컨트랙트가 Base 컨트랙트를 트리거하는 작업은 EVM 자체로는 불가능합니다. 체인은 기본적으로 서로 격리되어 있습니다. 크로스체인 브릿지가 이 공백을 메워 왔지만, 브릿지는 구조적으로 공격 표면이 넓어 업계 전반에서 보안 사고가 반복됐습니다.
더 보기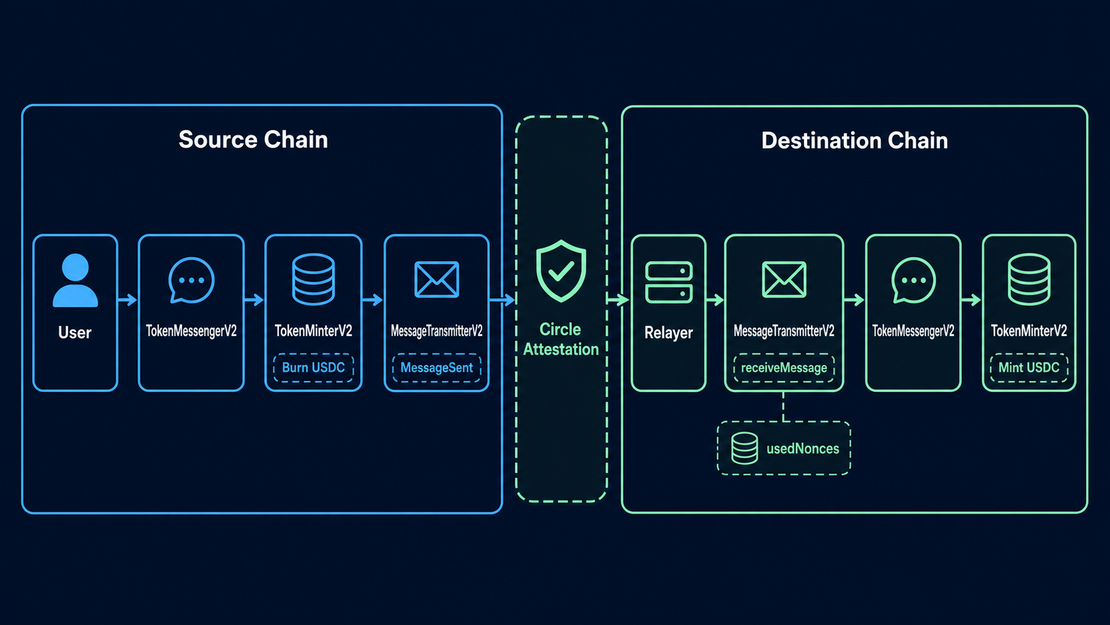
Circle CCTP V2 EVM 컨트랙트 파헤치기
- whackur
- Blockchain
- 2026년 6월 30일
USDC를 한 체인에서 다른 체인으로 옮기는 브리지 설계는 크게 두 갈래로 나뉩니다. 하나는 lock-and-mint입니다. 원본 토큰을 소스 체인(source chain)의 컨트랙트에 잠가 두고, 목적지 체인(destination chain)에서 래핑 토큰을 찍어냅니다. 다른 하나는 burn-and-mint입니다. 소스 체인에서 토큰을 아예 소각하고, 목적지 체인에서 같은 양을 새로 발행합니다. Circle이 만든 CCTP(Cross-Chain Transfer Protocol)는 후자입니다.
더 보기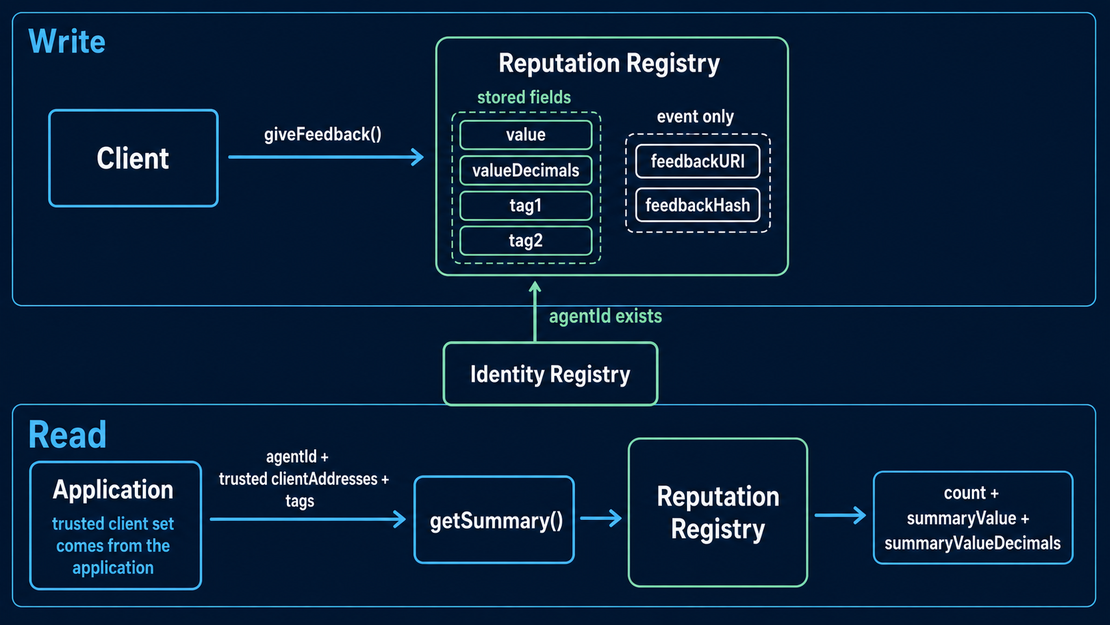
ERC-8004 에이전트 평판: 온체인 등록과 조회
- whackur
- Blockchain
- 2026년 6월 30일
지난 글에서 ERC-8004/8126/8196 신뢰 스택 개요를 살펴봤다. ERC-8004는 AI 에이전트 신원 등록(Identity Registry), 평판 기록(Reputation Registry), 작업 검증(Validation Registry) 세 레지스트리를 정의하는 Ethereum Draft 표준이다. 개념 설명은 그 글에 정리돼 있으니, 여기서는 중복하지 않는다.
더 보기
2026년 AI x 블록체인 지형도: Bittensor, DePIN, 에이전트 금융
- whackur
- Blockchain
- 2026년 6월 30일
AI와 블록체인을 결합한다는 말은 2020년대 초반에는 막연한 슬로건에 가까웠다. 2026년 현재, 그 결합이 네 개의 레이어로 구체화되고 있다. 분산 지능 레이어, 분산 GPU 컴퓨팅, 에이전트 금융, 머신 간 결제다. 각 레이어마다 살아남은 프로젝트와 사라진 프로젝트가 나뉘고 있다.
더 보기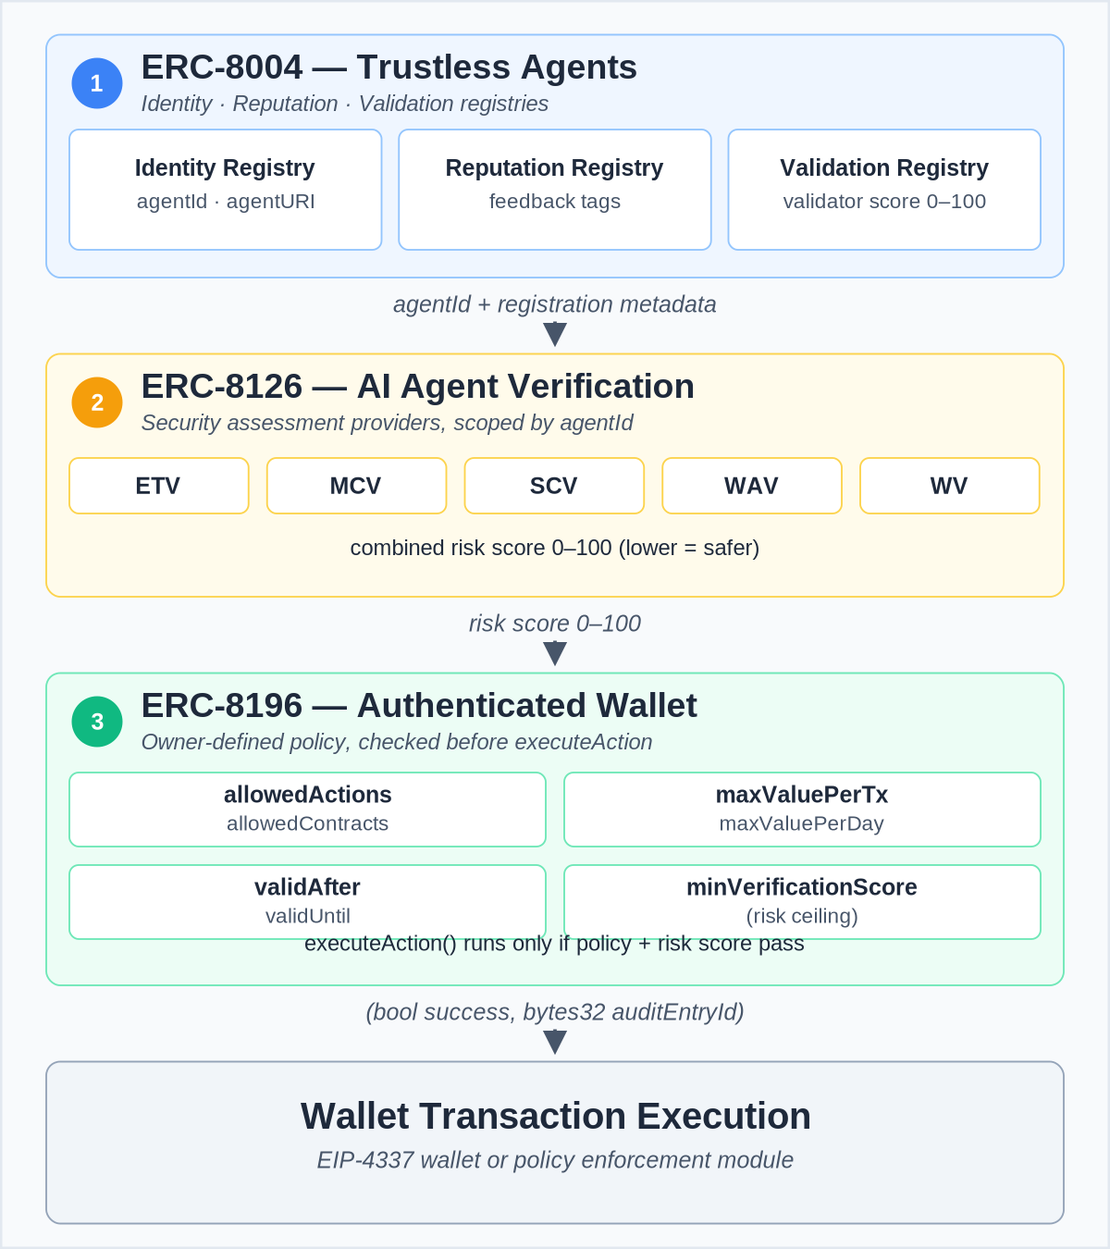
AI 에이전트 신뢰 스택: ERC-8004, ERC-8126, ERC-8196
- whackur
- Blockchain
- 2026년 6월 30일
AI 에이전트가 사용자를 대신해 자산을 쓰고, 컨트랙트를 호출하고, 유료 API에 접근하는 시대가 가까워지면서 “이 에이전트를 믿고 돈을 맡겨도 되는가"라는 질문이 실질적인 설계 문제가 됐다. 블록체인 커뮤니티는 이 문제를 세 계층으로 나눠 접근하고 있다. 신원 등록(ERC-8004), 보안 검증(ERC-8126), 정책 기반 실행(ERC-8196)이다.
더 보기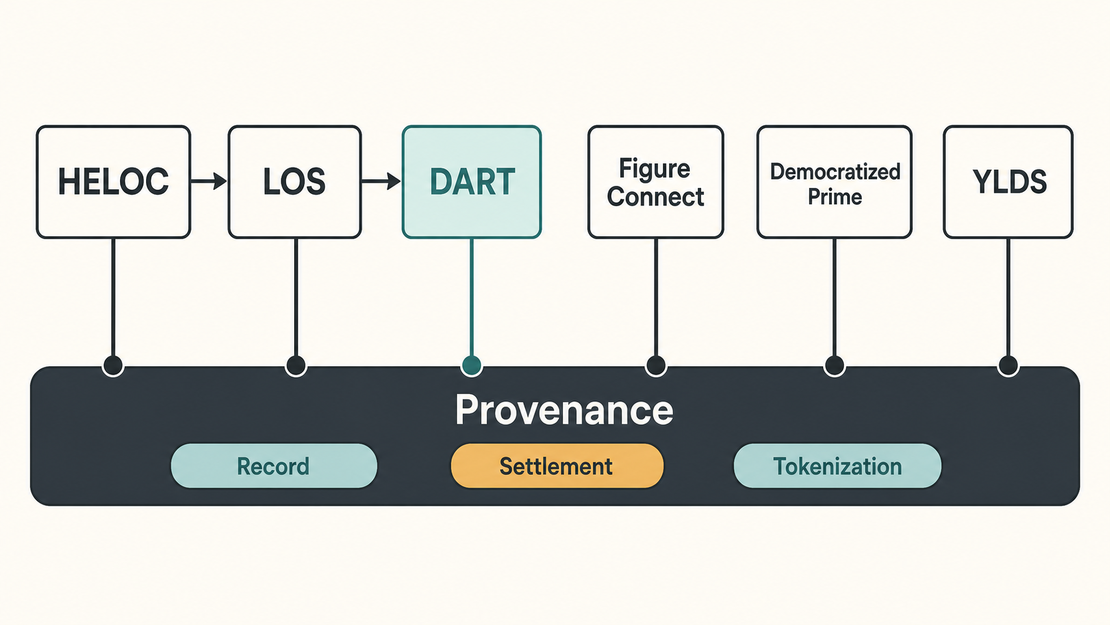
Figure: HELOC 대출에서 블록체인 자본시장 플랫폼으로
- whackur
- Blockchain
- 2026년 6월 30일
Figure라는 이름은 두 개의 회사를 가리킨다. 하나는 휴머노이드 로봇으로 알려진 Figure AI이고, 다른 하나는 이 글의 주제인 Figure Technology Solutions다. 두 회사는 무관하다.
더 보기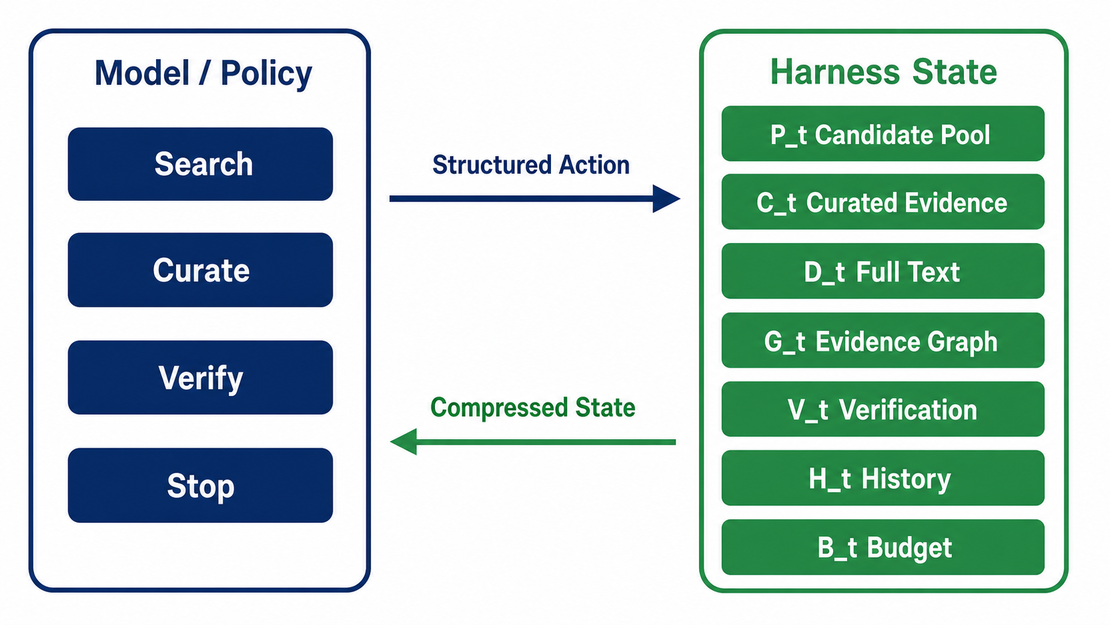
Harness-1: 상태 외부화 하네스로 학습한 검색 에이전트
검색 에이전트와 상태 관리 문제 검색 에이전트(search agent)는 질문 하나에 답하기 위해 여러 차례 검색을 반복하는 AI 에이전트다. 키워드 하나로 끝나는 단순 검색과 달리, 중간 결과를 보면서 다음 검색 전략을 조정하고, 문서를 비교하고, 주장의 근거가 실제로 있는지 확인하는 과정을 거친다. 금융 공시 분석, 복잡한 법령 해석, 멀티홉 사실 확인처럼 한 번의 검색으로 답이 나오지 않는 작업에 쓰인다.
더 보기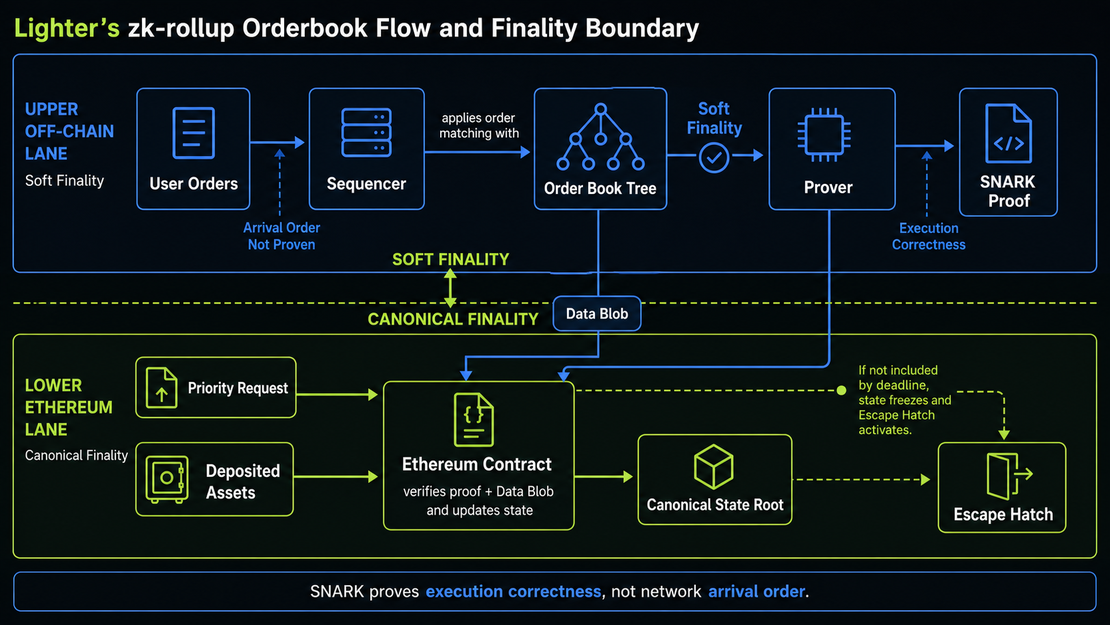
Lighter: Ethereum 위에서 동작하는 zk-SNARK 오더북 DEX
- whackur
- Blockchain
- 2026년 6월 30일
탈중앙화 거래소(DEX)는 크게 두 방식으로 나뉩니다. Uniswap처럼 유동성 풀 수식으로 가격을 결정하는 AMM(Automated Market Maker)과, 매도·매수 주문을 가격·시간 우선순위로 직접 대응시키는 오더북 방식입니다. AMM은 스마트 컨트랙트로 구현하기 쉽고 누구나 유동성을 공급할 수 있습니다. 반면 지정가 주문, 활발한 마켓 메이킹이 만드는 좁은 스프레드, 정밀한 가격 발견은 오더북 쪽의 영역입니다. Binance나 Coinbase 같은 중앙화 거래소(CEX)가 모두 오더북으로 동작하는 이유입니다.
더 보기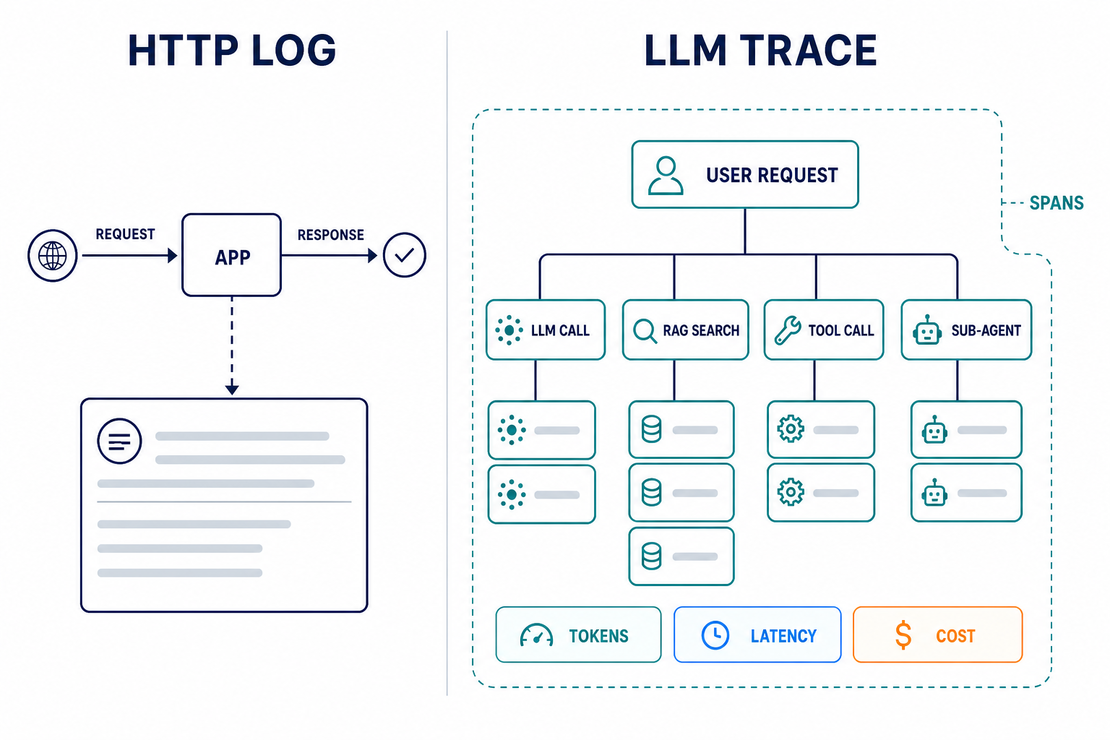
LLM Observability 오픈소스 스택: LangSmith 대안 5종 비교
LLM 앱이나 AI 에이전트를 운영하다 보면 “어떤 프롬프트가 실패했고, 어떤 도구 호출이 막혔고, 왜 에이전트가 루프에 빠졌는가"를 추적해야 하는 시점이 온다. LangSmith는 LangChain이 만든 상용 LLM 관측 플랫폼으로, trace 시각화, 프롬프트 버저닝, eval을 한 곳에서 제공한다. 사실상 기본 선택지로 자리 잡았지만, 사용량 기반 과금과 클라우드 중심 호스팅이 제약으로 작용해 자체 호스팅과 오픈소스를 선호하는 팀들이 대안을 찾기 시작했다. trace에는 사용자 입력과 내부 프롬프트가 그대로 담기기 때문에, 이 데이터가 외부 SaaS로 나가는 것 자체가 부담인 조직도 많다.
더 보기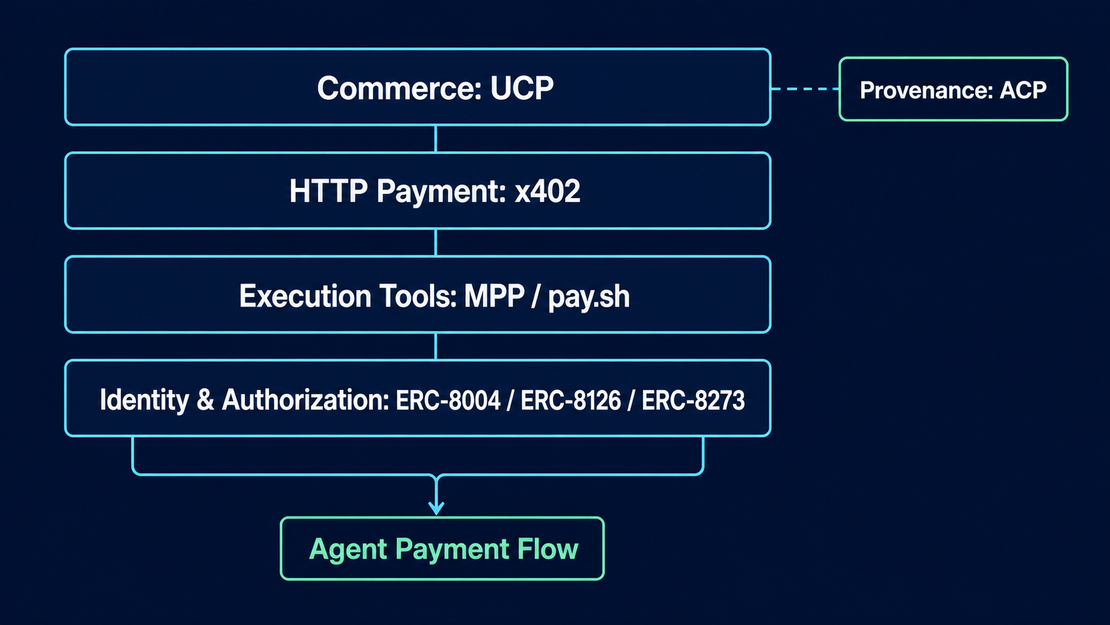
에이전트 결제 2026년 6월 동향: x402, UCP, MPP 구현 진전
- whackur
- Blockchain
- 2026년 6월 30일
2026년 6월 에이전트 결제 관련 오픈소스 프로토콜들이 “에이전트가 결제할 수 있는가"에서 “누가 결제 권한을 갖고, 어떻게 검증하며, 어떻게 추적하는가"로 초점을 이동했다. x402, UCP, MPP/pay.sh, ACP 각각에서 크고 작은 구현 변화가 있었다. 이 글은 2026년 6월 한 달간 관찰된 주요 변화를 정리한다. 수치와 커밋 내용은 직접 확인한 GitHub API·PyPI·npm registry 기준이다.
더 보기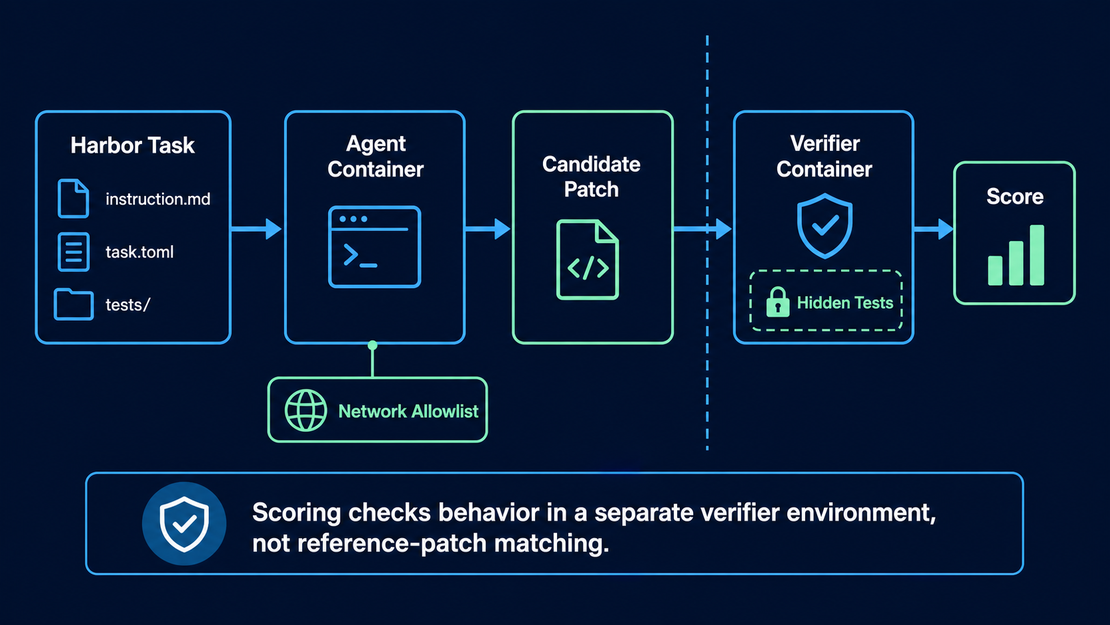
DeepSWE: 코딩 에이전트를 장기 과제로 평가하는 벤치마크
코딩 에이전트를 평가할 때 SWE-bench가 오랫동안 기준이었습니다. 그런데 SWE-bench의 태스크 대부분은 단일 파일 버그 수정이고, 정답이 이미 공개 커밋에 있습니다. 에이전트가 모델 학습 데이터에서 본 답을 그대로 재현하는 건지, 진짜로 코드를 이해하고 고치는 건지 구분하기 어렵습니다.
더 보기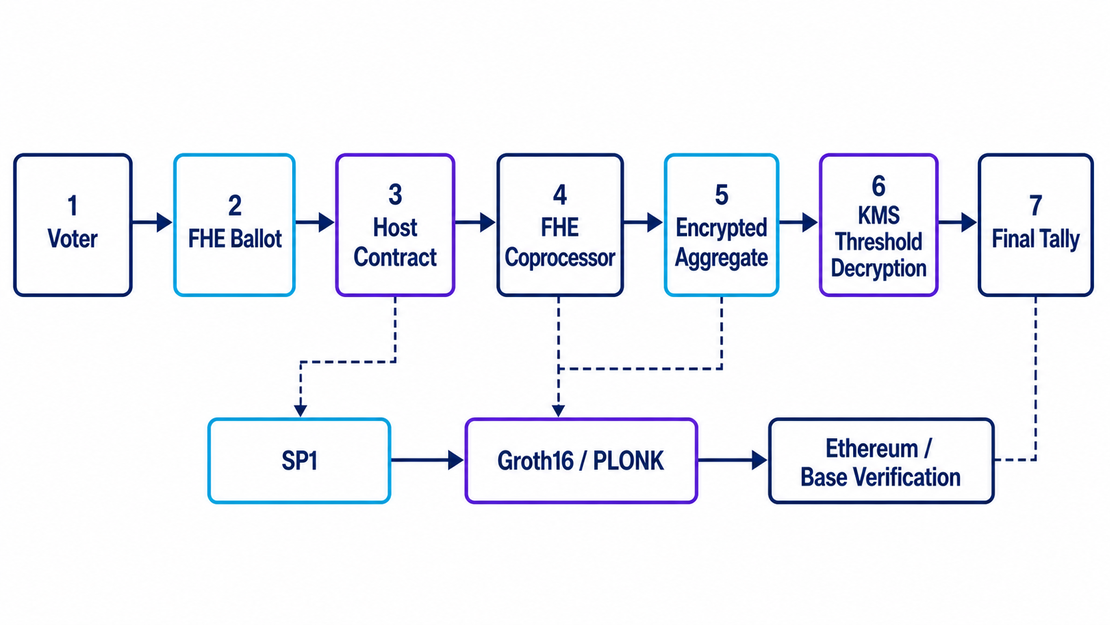
FHE·SP1·Groth16로 보는 비밀 투표 아키텍처
- whackur
- Blockchain
- 2026년 6월 30일
비밀 투표를 온체인에서 구현하면 즉시 세 가지 긴장이 생깁니다. 표 내용을 숨겨야 하는데 집계는 해야 하고, 오프체인 연산을 신뢰할 수 없는데 결과는 온체인에 확정해야 하며, EVM이 무거운 암호 연산을 직접 실행하기 어려운데 검증은 해야 합니다. FHE(완전 동형 암호), SP1 zkVM, Groth16 SNARK는 각각 이 세 가지 긴장을 담당합니다.
더 보기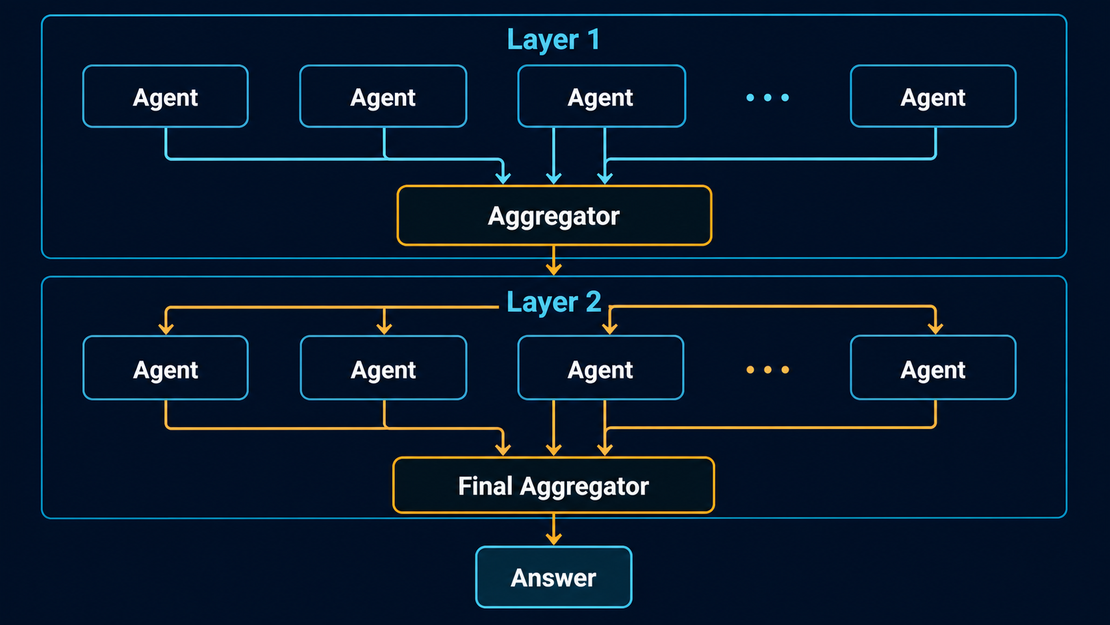
Mixture of Agents(MoA): 여러 LLM을 쌓아 GPT-4 Omni를 넘은 방법
모델 한 개를 더 크게 만드는 대신, 여러 모델을 계층으로 쌓아 서로의 출력을 다듬게 하는 방법이 있습니다. Together AI 연구진이 2024년 6월 발표한 논문 arXiv:2406.04692가 이 접근을 MoA(Mixture of Agents)라는 이름으로 정리했습니다. 오픈소스 모델만 조합한 MoA가 AlpacaEval 2.0에서 GPT-4 Omni를 7.6%p 앞섰습니다.
더 보기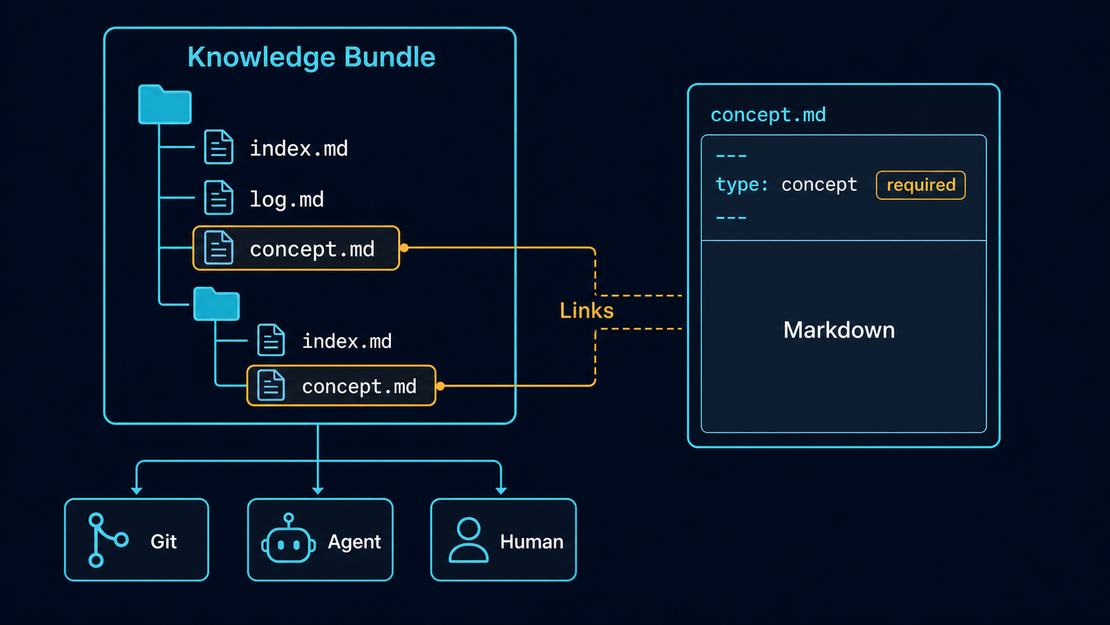
Open Knowledge Format(OKF): 에이전트용 지식 표현 개방형 포맷
AI 에이전트가 실패하는 원인을 들여다보면 모델 성능보다 맥락의 부재가 먼저 나오는 경우가 많습니다. 테이블 스키마, 지표 계산법, 장애 대응 런북, 두 시스템 사이의 join path가 카탈로그 벤더, 사내 위키, 코드 주석, 개인 노트에 흩어져 있고, 에이전트 개발자마다 같은 context assembly 문제를 처음부터 다시 풉니다.
더 보기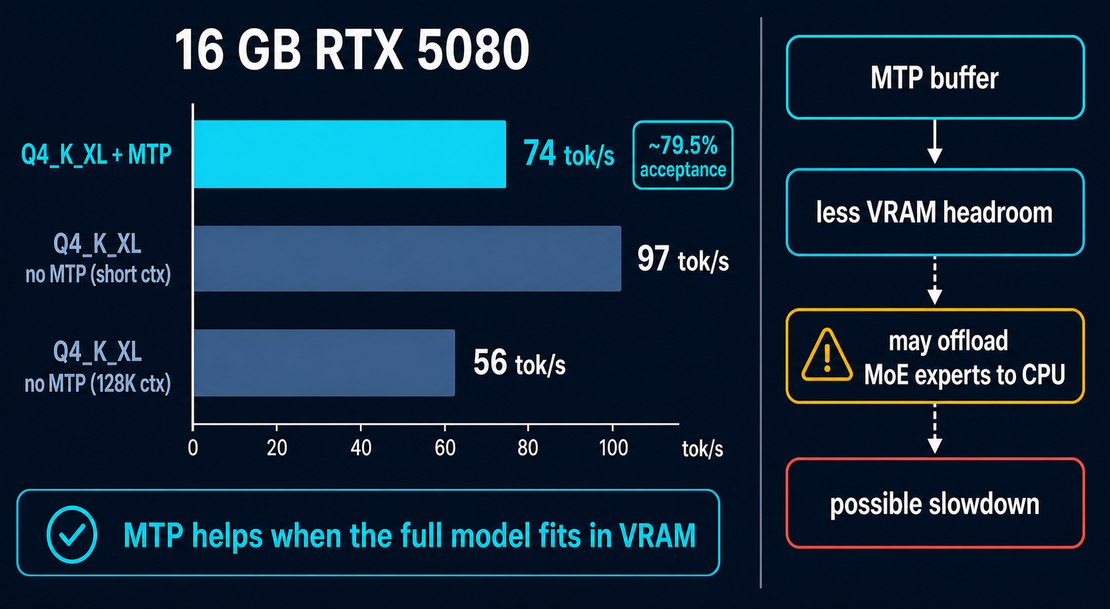
Qwen3.6-35B-A3B 커뮤니티 리뷰: uncensored 변종, MTP 가속, Hermes 호환
Alibaba가 2026년 4월 출시한 Qwen3.6-35B-A3B는 총 파라미터 35B에 토큰당 활성 파라미터 약 3B인 MoE 모델이다. 기본 컨텍스트 262K, 공식 SWE-bench 점수 73.4%. 출시 두 달 만에 로컬 LLM 커뮤니티에서 가장 많이 테스트된 35B급 모델이 됐다.
더 보기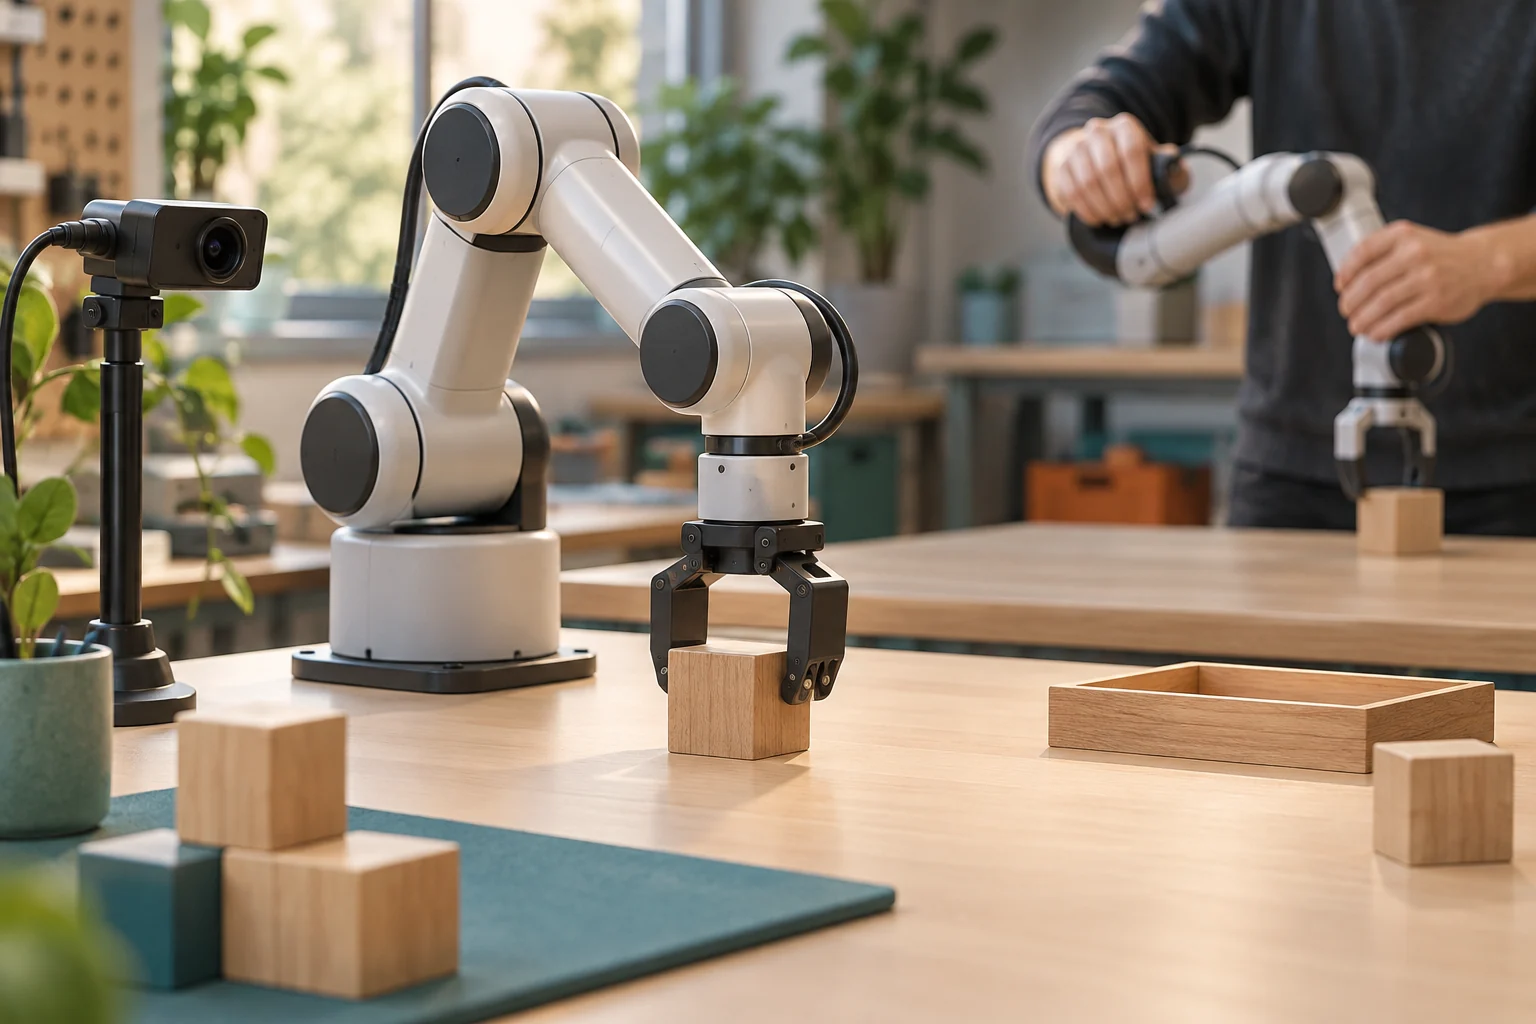
Robot Learning: A Tutorial (고전 로보틱스에서 VLA까지)
로봇 학습을 시작한다면, 한 작업을 사람이 원격 조작해 시연하고 ACT 같은 모방 학습 정책을 훈련한 뒤 같은 장치에서 제한된 조건으로 평가하는 경로가 합리적입니다. 고전 제어는 관절과 움직임을 다루고, 학습 정책은 관측에서 다음 행동을 고릅니다. VLA는 여기에 언어 지시와 사전학습을 더하지만, 보정·데이터 수집·실물 검증을 대신하지 않습니다. LeRobot 공식 문서도 첫 정책으로 ACT를 권장합니다.
더 보기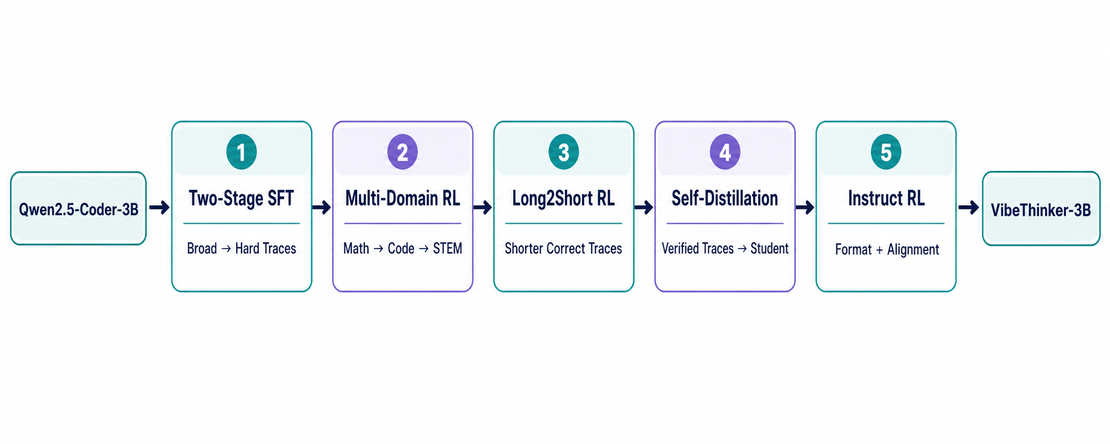
VibeThinker-3B: 검증 가능한 추론을 3B 모델에 압축한 실험
“작은 모델이 큰 모델을 이겼다"는 주장은 논문마다 나옵니다. 보통은 특정 벤치마크 하나에서의 결과를 두고 하는 말입니다. Sina Weibo의 WeiboAI팀이 2026년 6월 15일 공개한 VibeThinker-3B 역시 비슷한 구조의 주장을 합니다. 다만 논문이 조심스럽게 선을 긋는 부분이 있습니다. “작은 모델이 모든 걸 대체한다"가 아니라, 검증 가능한 추론(verifiable reasoning) 영역만큼은 작은 모델로 압축될 수 있다는 겁니다.
더 보기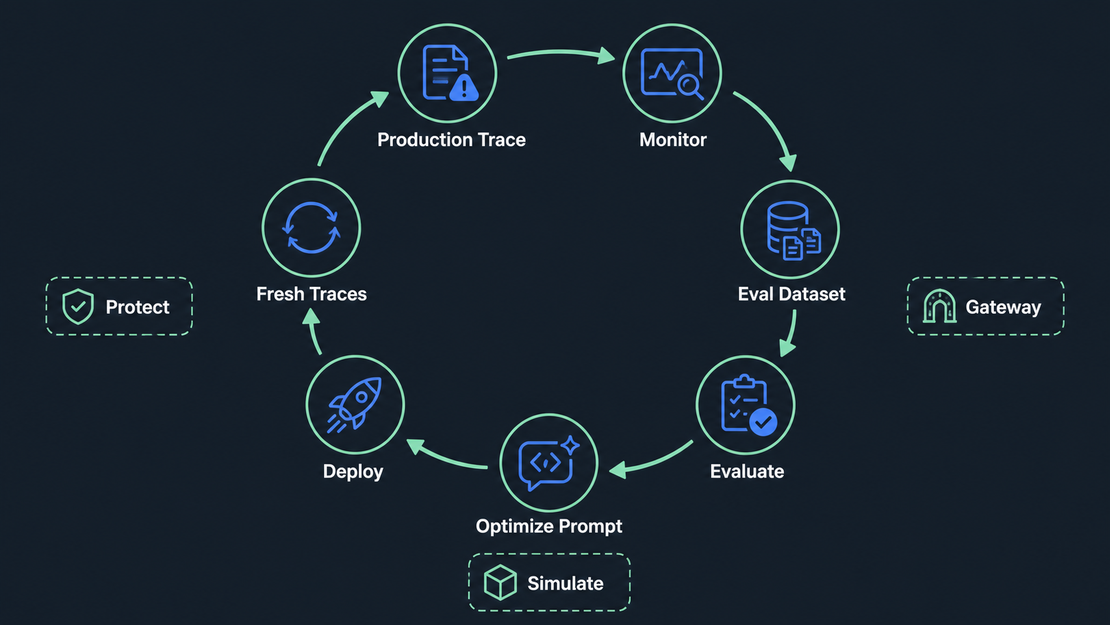
Future AGI: AI 에이전트 평가·관찰·개선을 한곳에서
AI 에이전트를 만들어 본 사람은 이 장면이 익숙합니다. 데모는 잘 돕니다. 그런데 프로덕션에 올리면 환각이 터지고, 뭐가 왜 틀렸는지 추적이 안 됩니다. 그래서 평가 도구 하나, 관측 도구 하나, 가드레일 하나를 따로 붙이죠. 진짜 문제는 이것들이 서로 말을 안 한다는 겁니다. 고치는 루프가 닫히지 않습니다.
더 보기